



MLCommons Revela Benchmark MLPerf Inference 2024: Resultados para Edge, Data Center, Mobile e Notebook
A MLCommons, organização independente que cura a suíte de benchmarks MLPerf, anunciou a mais recente rodada de pontuações MLPerf Inference. Os novos resultados são divididos em quatro classes de dispositivos — data center, edge, mobile e notebook — facilitando para compradores, fornecedores e pesquisadores comparar desempenho em cargas de trabalho reais.
Segmentação por Classe de Dispositivo
Separar pontuações por classe de dispositivo reflete os fatores de forma e perfis de desempenho distintos que caracterizam cada mercado. Como David Kanter, diretor executivo da MLCommons disse ao EE Times, "Se você fala de um notebook, provavelmente roda Windows; se fala de smartphone, provavelmente roda iOS ou Android." Ao isolar resultados mobile e notebook, o benchmark fornece insights mais claros sobre as capacidades dos aceleradores mais relevantes para cada caso de uso.
Modelos State-of-the-Art
Diferente da rodada anterior, focada principalmente em tarefas de visão, o benchmark atual incorpora cinco modelos modernos, prontos para produção:
- DLRM – motor de recomendação em larga escala
- 3D‑UNet – modelo de imagem médica para detecção de tumores em ressonâncias magnéticas
- RNN‑T – motor de fala para texto
- BERT – transformer de processamento de linguagem natural
- MobileNetEdge, SSD‑MobileNetv2, Deeplabv3, Mobile BERT – variantes otimizadas para mobile dos acima
Essas escolhas foram impulsionadas por um conselho consultivo que inclui especialistas da indústria de recomendação, imagem médica e domínios de fala, garantindo que os benchmarks reflitam as cargas de trabalho mais exigentes em produção hoje.
Desempenho em Data Center
Como esperado, GPUs da Nvidia dominam a classe data center. Na verdade, 85% do total de submissões foram alimentadas por hardware Nvidia, e a empresa varreu todas as categorias que entrou. O benchmark mostra uma lacuna de desempenho crescente: em um modelo básico de visão computacional, a Nvidia A100 entrega aproximadamente 30× a vazão de um CPU Intel Cooper Lake, e 237× mais rápida que um CPU comparável em cargas de trabalho de sistemas de recomendação. Paresh Kharya, diretor sênior de gerenciamento de produto da Nvidia, destaca que um único DGX‑A100 pode igualar o desempenho de um cluster de 1.000 nós CPU para tarefas de recomendação, oferecendo tremendo valor para escala.
A única entrada não-CPU, não-GPU nesta classe foi o acelerador Zebra da Mipsology, rodando em um FPGA Xilinx Alveo U250. O Zebra alcançou 4.096 queries ResNet por segundo em modo servidor versus 5.563 para uma Nvidia T4, e 5.011 amostras por segundo offline comparado a 6.112 para a T4.
Na categoria research‑development, o RecAccel da empresa taiwanesa Neuchips — um acelerador baseado em FPGA para DLRM — performou em par ou abaixo dos CPUs Intel Cooper Lake e ficou aquém dos resultados da Nvidia. Esses protótipos em estágio inicial demonstram a amplitude de hardware de IA emergente, mesmo que ainda não estejam comercialmente disponíveis.
Resultados na Camada Edge
Sistemas edge foram amplamente alimentados por A100, T4, AGX Xavier e Xavier NX da Nvidia. O design de referência da Centaur Technology, com seu processador x86 proprietário e coprocessador IA separado, bateu a Tesla T4 da Nvidia em latência single-stream ResNet, mas ficou atrás em vazão. A consultoria britânica dividiti apresentou uma ampla gama de pontuações — de Raspberry Pi a Nvidia AGX Xavier — destacando como escolhas de sistema operacional e uso de aceleradores on-chip podem influenciar resultados.
Novos entrantes do pool research‑development incluíram a empresa russa IVA Technologies e a startup coreana Mobilint. Embora nenhuma tenha alcançado desempenho revolucionário, sua inclusão mostra que aceleradores protótipos estão atingindo nível de maturidade de software que justifica benchmarking contra soluções comerciais.
Benchmarks Mobile e Notebook
A classe mobile viu três submissões comparáveis: Dimensity 820 da MediaTek (no Xiaomi Redmi 10X 5G), Snapdragon 865+ da Qualcomm (testado em Asus ROG Phone 3) e Exynos 990 da Samsung (usado no Galaxy Note 20 Ultra). A Samsung liderou em classificação de imagem e NLP, MediaTek se destacou em detecção de objetos, e Samsung novamente superou em segmentação de imagem. Os resultados ilustram que nenhum SoC único domina em todas as tarefas, ressaltando a importância de otimização específica por carga de trabalho.
A categoria notebook continha um único design de referência Intel com a futura GPU Xe‑LP. Embora o conjunto de dados limitado dificulte comparação detalhada, o Xe‑LP alcançou 2,5× maior vazão que o melhor SoC mobile em segmentação de imagem (DeeplabV3) e 1,15× melhor em detecção de objetos (SSD‑MobileNetv2).
Olhando Adiante
Kanri enfatiza o compromisso da MLCommons com diversidade no ecossistema de benchmark. A organização incentiva participação de empresas não-Nvidia, não-Intel e pequenas, com uma divisão aberta que permite testar qualquer rede ou modelo. "Também estamos trabalhando em adicionar uma dimensão de medição de potência para a próxima rodada", diz Kanter, convidando a comunidade a ajudar a desenvolver as ferramentas necessárias.
Para uma lista completa e detalhada de resultados MLPerf Inference, clique aqui.
Fonte: EE Times
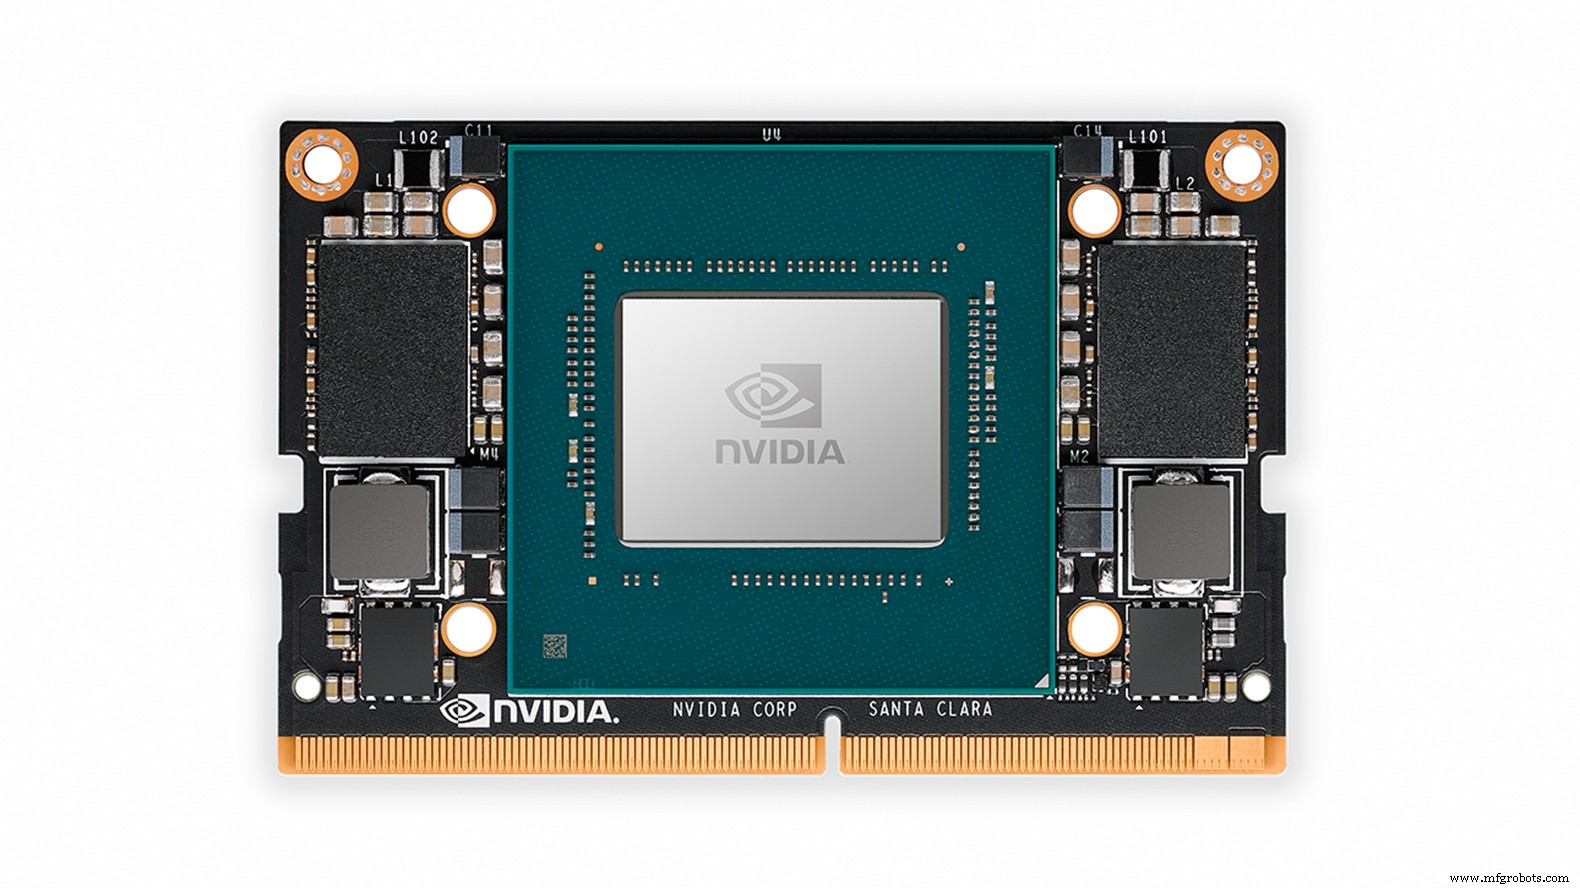
Resultados edge dominados por GPUs Nvidia, incluindo Jetson Xavier NX
Integrado
- STMicroelectronics LSM6DSOX: Sensor Inercial Machine-Learning-Enabled para Activity Tracking Preciso e Energy-Efficient
- ADLINK e Charles Industries Revelam Primeira Solução Completa Micro‑Edge AI/ML para Implantações 5G em Postes
- NXP Acelera IA de Borda com Toolkit eIQ
- Edge AI: Por Que o Processamento Está a Migrar para a Camada do Dispositivo
- Aumente a Produtividade com Recursos Avançados de Centros de Usinagem Vertical
- Aumentar a Eficiência do Edge Computing com uma Rede Wi‑Fi Robusta
- Aprendizado de Máquina Acelera Segurança de Oleodutos: Detecção de Falhas em Tempo Real Economiza $10M
- Edge Computing: O Novo Coração da Era da Nuvem
- Johnford ST-80 CH: Centro de Torneamento CNC de Precisão para Indústrias Pesadas
- VTC 100-4 de Quatro Eixos de Precisão: Máquina de Torneamento de Eixos de Alto Desempenho