



Novo Chip de IA de Baixa Precisão da IBM Alcança 25,6 TFLOPS Treino e 102,4 TOPS Inferência
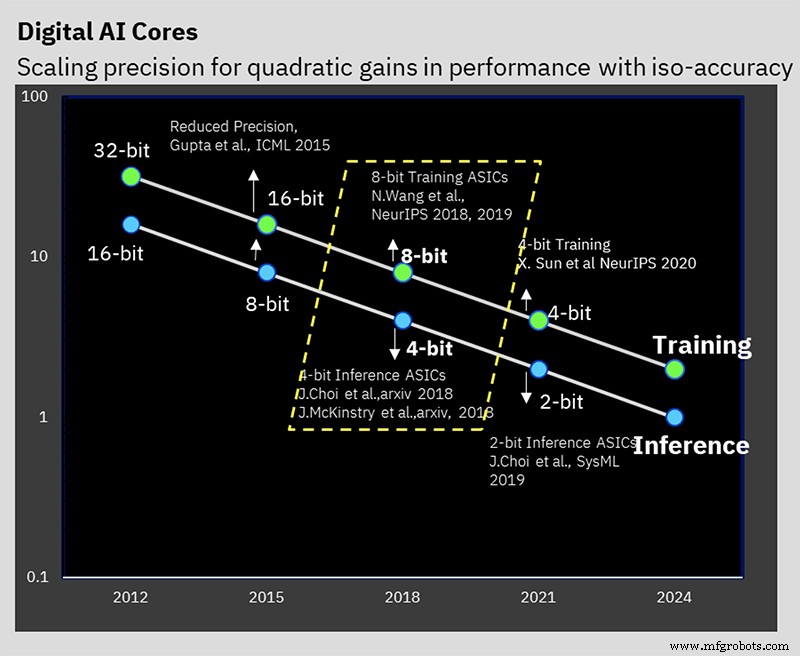
No ISSCC 2024, a IBM Research revelou um protótipo de 7 nm que incorpora anos de trabalho em treino e inferência de IA de baixa precisão. O chip entrega treino de 16 e 8 bits, bem como inferência de 4 e 2 bits — bem abaixo da norma da indústria de treino 32 bits / inferência 8 bits.
Reduzir a precisão numérica corta requisitos de computação e energia, mas a IBM também introduziu várias otimizações arquiteturais que aumentam ainda mais a eficiência. O desafio principal é reduzir a precisão sem prejudicar a acurácia — um problema que a IBM tem enfrentado no nível algorítmico há anos.
O Centro de Hardware de IA da IBM, lançado em 2019, visa aumentar o desempenho de computação de IA em 2,5× anualmente, visando uma melhoria de 1.000× em FLOPS/W até 2029. Metas tão ambiciosas são impulsionadas pelo crescimento explosivo de modelos de IA — especialmente sistemas NLP de trilhões de parâmetros — e pela pegada de carbono crescente de seu treinamento.
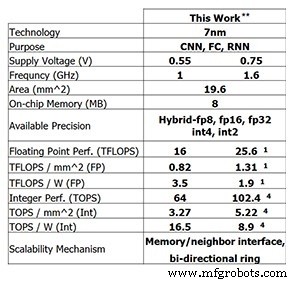
No protótipo, o chip de 4 cores atinge 25,6 TFLOPS para treino de 8 bits, enquanto entrega 102,4 TOPS para inferência inteira de 4 bits (ambos medidos a 1,6 GHz e 0,75 V). Reduzir o clock para 1 GHz e a tensão para 0,55 V melhora a eficiência energética para 3,5 TFLOPS/W (FP8) ou 16,5 TOPS/W (INT4).
Treino de Baixa Precisão
Este desempenho baseia-se em anos de trabalho algorítmico em técnicas de treino e inferência de baixa precisão. O chip é o primeiro a suportar o formato FP8 híbrido da IBM, introduzido no NeurIPS 2019, que permite treino de 8 bits enquanto reduz pela metade a computação do treino de 16 bits sem comprometer resultados.
"Treino de baixa precisão é desafiador, mas treino de 8 bits é alcançável com os formatos numéricos certos", disse Kailash Gopalakrishnan, IBM Fellow e gerente sênior para arquiteturas de aceleradores e machine learning. "Os formatos numéricos certos, aplicados aos tensores corretos, são críticos."
O FP8 híbrido combina dois formatos: um para pesos e ativações na passagem forward, e outro para gradientes na passagem backward. O treino requer ambas as passagens, enquanto a inferência usa apenas o formato forward.
"Descobrimos que tensores forward precisam de maior fidelidade — mais precisão na mantissa — enquanto gradientes demandam faixa dinâmica mais ampla com expoente maior. Essa troca levou à divisão 1-4-3 (sinal-expoente-mantissa) para forward e expoente de 5 bits para backward, dando faixa dinâmica de 232. Nosso hardware agora suporta ambas as variantes."
Acumulação Hierárquica
A técnica de "acumulação hierárquica" da IBM reduz a precisão durante a acumulação junto com pesos e ativações. O treino FP16 tradicional acumula em aritmética de 32 bits para preservar acurácia, mas o esquema de 8 bits acumula em FP16. Agrupando acumulações longas em pedaços menores e somando-os, o chip minimiza erros de arredondamento sem sacrificar os benefícios da menor precisão.
"Adicionar milhares de números sequencialmente pode degradar a precisão", explicou Gopalakrishnan. "Dividir a acumulação em pedaços mantém a soma precisa enquanto mantém o hardware enxuto."
Inferência de Baixa Precisão
Enquanto a maioria dos motores de inferência usa INT8, a IBM demonstrou que aritmética inteira de 4 bits pode igualar acurácia state-of-the-art. Após quantização, um passo de treino ciente de quantização reduz a perda de acurácia para menos de 0,5%, o que é aceitável para muitas aplicações.
Ring On-Chip
O chip incorpora uma network-on-chip otimizada para deep learning, permitindo que cores façam multicast de dados eficientemente. Isso reduz tráfego de memória off-chip e demandas de largura de banda.
"Desacoplamos a frequência de operação do ring dos cores, permitindo otimização independente e velocidades de core mais altas sem a latência de fio longo do ring", disse Ankur Agrawal, membro da equipe de pesquisa em machine learning e arquiteturas de aceleradores.
Gerenciamento de Energia
A IBM introduziu um esquema de frequency-scaling que mantém o chip perto de seu envelope de potência durante a carga de trabalho. Definindo tensão e frequência iniciais agressivamente, o chip mantém alto desempenho durante fases computacionalmente pesadas e se adapta a menor demanda sem mudanças de tensão custosas.
"Cargas de trabalho de deep learning têm picos e vales de potência distintos", observou Agrawal. "Nossa estratégia mantém o consumo de energia estável, transformando vales em ganhos de desempenho."
Chip de Teste
O design de 4 cores equilibra complexidade de conectividade com tamanho de core, oferecendo arquitetura escalável. A IBM prevê chips de 1-2 cores para dispositivos edge e chips de 32-64 cores para implantações em data center, todos capazes de FP16, FP8 híbrido, INT4 e INT2.
"Diferentes domínios de aplicação demandam diferentes trocas de precisão e energia", disse Gopalakrishnan. "Nosso canivete suíço de formatos nos permite atingir cada caso de uso sem comprometer eficiência."
Complementando o hardware, a IBM Research lançou a pilha de compilador "Deep Tools", alcançando 60-90% de utilização no chip.
Segundo entrevista anterior, chips de IA de baixa precisão baseados nesta arquitetura devem chegar ao mercado dentro de dois anos.
>> Este artigo foi publicado originalmente em nosso site irmão, EE Times.
Conteúdo Relacionado
- Chips de IA mantêm acurácia com redução de modelo
- Treinando modelos de IA no edge
- A corrida está aberta para IA no edge
- IA no edge desafia tecnologia de memória
- Grupo de engenharia busca levar IA de 1mW ao edge
- Aplicação de redes neurais para tarefas de pequena escala
- Pesquisa de IC de IA explora arquiteturas alternativas
Para mais Embedded, assine a newsletter semanal por e-mail do Embedded.
Integrado
- Escolhas de Design Bluetooth Mesh: Módulo vs. Dispositivo Discreto
- Breakthrough do MIT: Chip de ID Criptográfico de 1,6 mm² Combate Contrafação com Backscatter Terahertz
- Gerenciando Manutenção em Meio a Cortes de Pessoal: Terceirização Estratégica e Monitoramento Contínuo
- Rockwell Automation Faz Parceria com ATCC para Expandir Treinamento de Automação no Centro de Minnesota
- Pesquisadores Revelam BrakTooth: 16 Vulnerabilidades no Bluetooth Classic Expõem 1.400+ Dispositivos ESP32
- Como IBM Watson Impulsiona Inovação IA em Todas as Indústrias
- Aumente seu ROI de Marketing com Precisão de Agência
- Aumente ROI de Marketing com Precisão de Agência
- IBM: Aumentando Confiabilidade e Segurança de Ativos com Soluções EAM Proativas
- Usinagem de Precisão: Construindo Sistemas Hidráulicos Superiores para Manufatura e Construção