



Mínimos Locais no Treinamento de Redes Neurais: Mito ou Realidade?
Entendendo o papel de mínimos locais no treinamento de perceptrons e redes neurais multicamadas.
Na série de redes neurais do AAC, examinamos muitos aspectos de design e treinamento de perceptrons multicamadas. Antes de mergulhar em mínimos locais, revise os posts anteriores:
- Como Realizar Classificação Usando Rede Neural: O Que é o Perceptron?
- Como Usar Exemplo Simples de Perceptron para Classificar Dados
- Como Treinar um Perceptron Básico
- Entendendo Treinamento Simples de Rede Neural
- Introdução à Teoria de Treinamento para Redes Neurais
- Entendendo Taxa de Aprendizado em Redes Neurais
- Machine Learning Avançado com Perceptron Multicamada
- Função de Ativação Sigmoid: Ativação em Perceptrons Multicamadas
- Como Treinar um Perceptron Multicamada
- Entendendo Fórmulas de Treinamento e Backpropagation para Perceptrons Multicamadas
- Arquitetura de Rede Neural para Implementação Python
- Como Criar um Perceptron Multicamada em Python
- Processamento de Sinais Usando Redes Neurais: Validação no Design de Redes Neurais
- Datasets de Treinamento para Redes Neurais: Como Treinar e Validar uma Rede Neural Python
- Quantas Camadas e Nós Ocultos uma Rede Neural Precisa?
- Como Aumentar a Precisão de uma Rede Neural com Camada Oculta
- Incorporando Nós de Bias em Sua Rede Neural
- Entendendo Mínimos Locais no Treinamento de Redes Neurais
Treinar uma rede neural é uma tarefa de otimização sofisticada. Embora raramente precisemos entender cada nuance matemática para construir modelos eficazes, o fenômeno de mínimos locais permanece uma consideração teórica crítica.
Por Que Mínimos Locais Importam
Historicamente, mínimos locais eram vistos como grande obstáculo ao treinamento, especialmente para mapeamentos entrada-saída complexos. Pesquisas recentes — como estudos sobre geometria de superfície de perda (ex.: Choromanska et al., 2015; Dauphin et al., 2014) — sugerem que arquiteturas modernas e heurísticas de treinamento reduzem a severidade deste problema. Ainda assim, entender mínimos locais nos ajuda a apreciar como otimizadores baseados em gradiente navegam paisagens de perda de alta dimensionalidade e por que certas estratégias de treinamento podem escapar de pontos subótimos.
Definindo um Mínimo Local
Considere uma superfície de erro quadrática simples: f(x, y) = x² + y². Qualquer ponto que produza o menor erro possível — chamado mínimo global — é o alvo do treinamento. Em uma tigela perfeitamente convexa, o gradiente descendente sempre convergirá para este ponto independentemente da posição inicial.
Na prática, superfícies de perda estão longe de ser convexas. Elas podem conter múltiplos vales e platôs, como ilustrado abaixo:
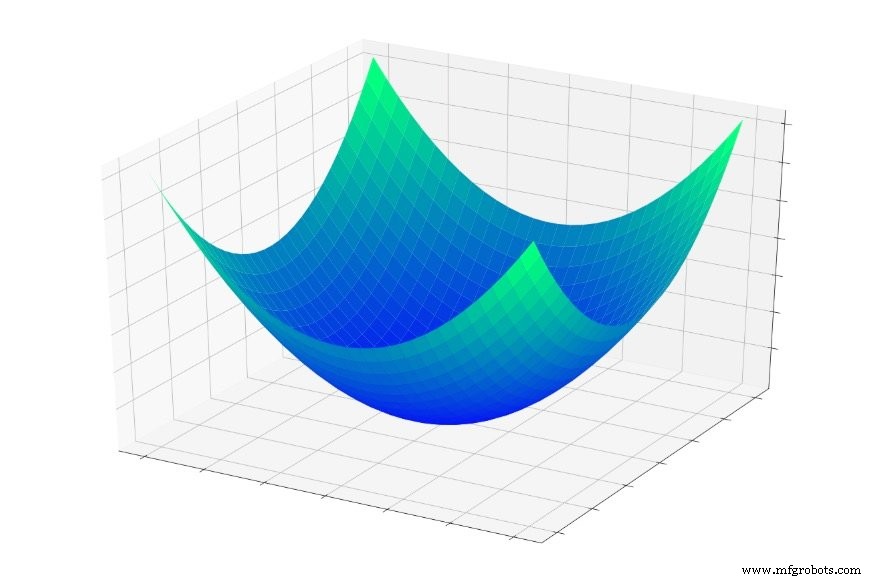
Quando o otimizador entra em uma bacia rasa, pode se estabelecer em um mínimo local — o ponto mais baixo dentro daquela região local — mas não o global. Sem conhecimento global, o algoritmo não pode "subir" de volta para explorar vales mais profundos.
Precisamos Realmente do Mínimo Global?
Embora atingir o mínimo global frequentemente correlacione com menor erro de treino, nem sempre é sinônimo de melhor generalização. Redes altamente expressivas que atingem ajuste perfeito nos dados de treino podem overfitar, reduzindo desempenho em amostras não vistas. Nesses casos, um mínimo local bem localizado pode fornecer solução mais robusta. Além disso, pontos de sela — regiões planas onde gradientes desaparecem em algumas direções — podem representar desafio maior que mínimos locais simples (Goodfellow et al., 2015).
Implicações Práticas
Práticas modernas de treinamento mitigam efeitos de mínimos locais através de técnicas como gradiente descendente estocástico, agendamento de taxa de aprendizado, momentum, otimizador Adam e esquemas de inicialização de pesos. Métodos de ensemble e regularização (dropout, L2) também ajudam o modelo a evitar overfitting no mínimo global.
Conclusão
Mínimos locais permanecem um aspecto fascinante do treinamento de redes neurais. Entender seu impacto informa a escolha de arquitetura, otimizador e estratégia de regularização. No próximo artigo, exploraremos técnicas concretas — como annealing de taxa de aprendizado e otimizadores adaptativos — que guiam redes para mínimos desejáveis.
Robô industrial
- Entendendo Topologias de Rede: De Ponto-a-Ponto a Anel e Estrela
- Entendendo Protocolos de Rede: Da Camada Física à Arbitragem Avançada
- STMicroelectronics Lança STM32Cube.AI: Redes Neurais Embarcadas para Dispositivos Edge
- CEVA Revela NeuPro-S: Processador IA Next-Gen para Inferência Deep Neural Network na Edge
- Adicionando Nós de Bias a Perceptron Multicamada em Python
- Otimizando Tamanho da Camada Oculta para Aumentar Precisão de Rede Neural
- Redes Neurais Artificiais Impulsionam Desempenho de Comunicações Sem Fio
- Treinar Grande Rede Neural Gera 284.000 kg de CO₂ — Equivalente a 5 Carros
- Corte a Laser de Fibra Robótico vs Corte a Plasma: Diferenças-Chave e Escolha da Solução Certa
- Rede Neural do NIST Detecta Minúsculas Formas Geométricas em Imagens Densas com 97% de Precisão