



Construindo um Autoencoder Variacional com TensorFlow: Guia Prático
Domine os fundamentos de autoencoders, descubra como autoencoders variacionais os aprimoram e percorra uma implementação TensorFlow passo a passo.
Inteligência artificial remodelou incontáveis setores, e compressão de dados não é exceção. Autoencoders — especialmente suas variantes variacionais — fornecem esquemas de compressão generativos poderosos que são eficientes e expressivos. Este guia quebra os conceitos centrais e o conduz por uma implementação completa TensorFlow usando o dataset MNIST.
Aplicações de Autoencoders
Autoencoders são amplamente adotados em campos que vão de tradução automática neural a descoberta de fármacos, desruído de imagem e detecção de anomalias. Sua capacidade de aprender representações latentes comprimidas e informativas os torna uma ferramenta essencial para pipelines modernos de ML.
Componentes Principais de um Autoencoder
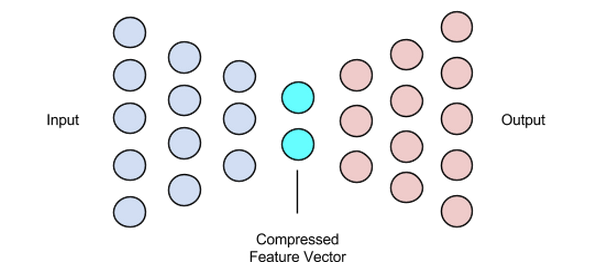
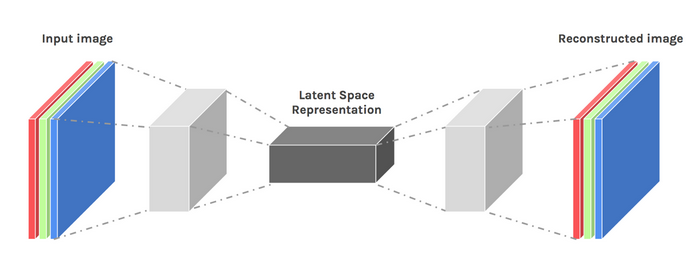
Diferente de redes neurais típicas, autoencoders possuem um gargalo que força uma representação latente de baixa dimensionalidade. A arquitetura compreende três partes primárias:
- Encoder — comprime dados de entrada em um vetor latente.
- Gargalo (Vetor Latente) — armazena as características mais salientes.
- Decoder — reconstrói a entrada a partir do vetor latente.
O encoder e decoder são geralmente redes feed-forward, mas variantes especializadas — convolucionais para imagens, recorrentes para texto — são comuns na prática.
Encoder
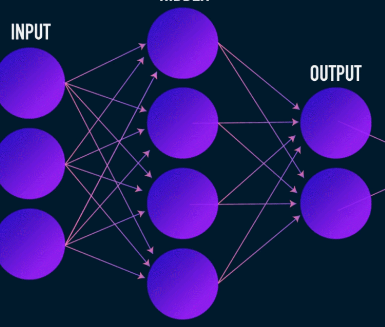
O encoder mapeia entradas de alta dimensionalidade (ex.: imagens 28×28 pixels) para um vetor latente compacto. Durante o treinamento, ele otimiza seus pesos para que o vetor latente capture informação essencial, permitindo que o decoder reconstrúa a entrada com perda mínima.
Gargalo (Vetor Latente)
O tamanho do vetor latente é um trade-off: muito pequeno e você perde detalhes críticos; muito grande e você prejudica a compressão e infla computação. Selecionar uma dimensionalidade apropriada é crucial para desempenho do modelo.
Decoder
O decoder é um espelho do encoder, transformando o vetor latente de volta ao espaço de dados original. Geralmente usa convoluções transpostas ou camadas de upsampling para recuperar resolução espacial.
Treinando Autoencoders
Autoencoders são treinados ponta a ponta usando otimizadores baseados em gradiente como Adam. O objetivo é minimizar uma perda de reconstrução que quantifica a discrepância entre a entrada e sua reconstrução.
Funções de Perda
Escolhas comuns incluem L1, L2 e erro quadrático médio (MSE). Cada uma mede quão próxima a saída está da entrada, tornando-as adequadas para tarefas de reconstrução generativa.
Variantes de Rede
Embora perceptrons multicamadas (MLPs) possam servir como encoders/decoders, redes neurais convolucionais (CNNs) são preferidas para dados de imagem devido à sua consciência espacial. Redes recorrentes se destacam com dados sequenciais como texto.
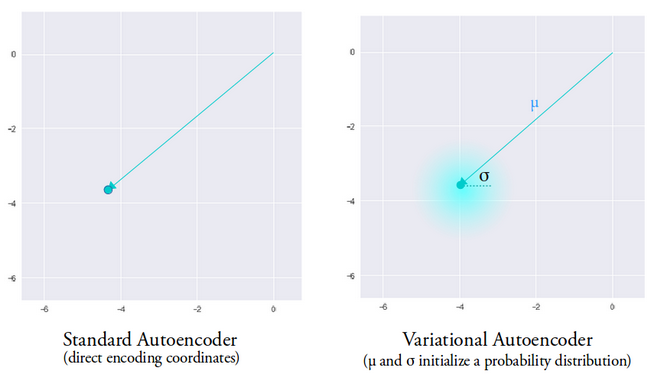
Autoencoders padrão carecem de criatividade — eles só podem reproduzir dados vistos durante o treinamento. Introduzir estocasticidade via framework variacional desbloqueia capacidades generativas.
Autoencoders Variacionais (VAEs)
VAEs modificam a arquitetura padrão de duas formas:
- O encoder produz um vetor de média e um vetor de variância, definindo uma distribuição Gaussiana.
- Um termo de divergência Kullback-Leibler (KL) é adicionado à perda para regularizar a distribuição latente em direção a uma Gaussiana unitária.
Durante inferência, o encoder amostra um vetor latente da distribuição aprendida, permitindo que o decoder gere reconstruções diversas e realistas. Esta estocasticidade mitiga as descontinuidades frequentemente observadas em autoencoders determinísticos.
Implementação TensorFlow
Abaixo está uma implementação TensorFlow concisa, pronta para produção, de um VAE convolucional treinado no MNIST.
Preparação dos Dados
(train_images, _), (test_images, _) = tf.keras.datasets.mnist.load_data()
train_images = train_images.reshape(-1, 28, 28, 1).astype('float32')
test_images = test_images.reshape(-1, 28, 28, 1).astype('float32')
train_images /= 255.
test_images /= 255.
train_images[train_images >= .5] = 1.
train_images[train_images < .5] = 0.
test_images[test_images >= .5] = 1.
test_images[test_images < .5] = 0.
TRAIN_BUF = 60000
BATCH_SIZE = 100
TEST_BUF = 10000
train_dataset = tf.data.Dataset.from_tensor_slices(train_images).shuffle(TRAIN_BUF).batch(BATCH_SIZE)
test_dataset = tf.data.Dataset.from_tensor_slices(test_images).shuffle(TEST_BUF).batch(BATCH_SIZE)
Definição do Modelo VAE
class CVAE(tf.keras.Model):
    def __init__(self, latent_dim):
        super(CVAE, self).__init__()
        self.latent_dim = latent_dim
        self.inference_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(28, 28, 1)),
            tf.keras.layers.Conv2D(32, 3, strides=2, activation='relu'),
            tf.keras.layers.Conv2D(64, 3, strides=2, activation='relu'),
            tf.keras.layers.Flatten(),
            tf.keras.layers.Dense(latent_dim + latent_dim), # mean & logvar
        ])
        self.generative_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(latent_dim,)),
            tf.keras.layers.Dense(7*7*32, activation='relu'),
            tf.keras.layers.Reshape((7, 7, 32)),
            tf.keras.layers.Conv2DTranspose(64, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(32, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(1, 3, padding='SAME'), # logits
        ])
    @tf.function
    def sample(self, eps=None):
        if eps is None:
            eps = tf.random.normal(shape=(100, self.latent_dim))
        return self.decode(eps, apply_sigmoid=True)
    def encode(self, x):
        mean, logvar = tf.split(self.inference_net(x), num_or_size_splits=2, axis=1)
        return mean, logvar
    def reparameterize(self, mean, logvar):
        eps = tf.random.normal(shape=mean.shape)
        return eps * tf.exp(logvar * .5) + mean
    def decode(self, z, apply_sigmoid=False):
        logits = self.generative_net(z)
        if apply_sigmoid:
            return tf.sigmoid(logits)
        return logits
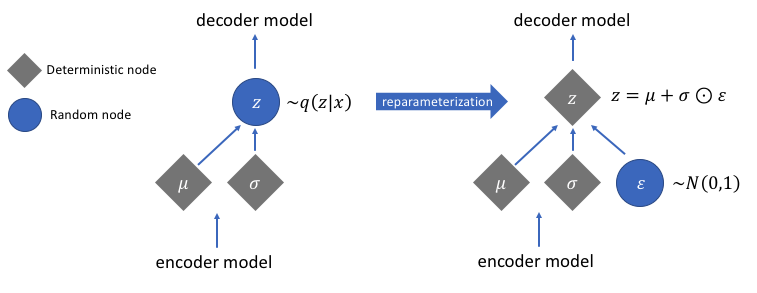
Funções auxiliares chave — encode, reparameterize e decode — encapsulam o fluxo de trabalho do VAE. O método reparameterize implementa o truque de reparametrização, permitindo fluxo de gradiente através de amostragem estocástica.
Truque de Reparametrização
Amostrar um vetor latente diretamente de uma distribuição quebra diferenciabilidade. Expressando a amostra como z = mean + std * eps onde eps ~ N(0,1), gradientes propagam através de mean e std. O termo de divergência KL alinha ainda mais a distribuição aprendida com uma normal padrão, promovendo espaços latentes suaves.
Resumo Rápido dos Passos
- Definir arquiteturas de encoder e decoder.
- Implementar o truque de reparametrização para permitir back-propagação.
- Treinar o modelo ponta a ponta, minimizando perda de reconstrução mais divergência KL.
Para o código completo e scripts de treinamento adicionais, visite o tutorial oficial do TensorFlow.
Crédito da imagem: Chiman Kwan (modificado)
Robô industrial
- Como Impressoras 3D Fabricam Peças Metálicas: Do Pó à Precisão
- Reduzindo Desperdício e Custos de Energia com Robôs Autônomos
- Protegendo Tecnologia em Nuvem: Melhores Práticas para Proteção de Dados e Mitigação de Riscos
- Aproveitando Dados na Internet da Confiabilidade: Estratégias para Gestão Eficaz
- Aproveitando IoT para Big Data de HVAC: Otimizando Energia, Conforto e Qualidade do Ar – Parte 2
- Dando Vida à IoT com IBM e Tech Data – Parte 2
- Transformando IoT em Realidade: Insights da Tech Data e IBM – Parte 1
- Roteiros Impulsionados por IA: Guia Estratégico para Empresas da Cadeia de Suprimentos
- Aproveitando Mineração de Dados e IA: Blueprint de Marcas Industriais para Prosperar no E-Commerce
- Otimizando Vida Útil de Ferramentas com Dados de Máquina: Um Guia Moderno