



Otimizando Tamanho da Camada Oculta para Aumentar Precisão de Rede Neural
Neste artigo, realizaremos experimentos de classificação e analisaremos como a dimensionalidade da camada oculta impacta o desempenho de uma rede neural.
Aprenda como ajustar a camada oculta em um Perceptron pode melhorar precisão, reduzir tempo de treino e manter latência aceitável — tudo demonstrado com implementação Python e datasets reais.
Antes de mergulhar, revise posts anteriores em nossa série de redes neurais para construir base sólida:
- Como Realizar Classificação Usando Rede Neural: O Que é o Perceptron?
- Como Usar Exemplo Simples de Perceptron para Classificar Dados
- Como Treinar um Perceptron Básico
- Entendendo Treinamento Simples de Rede Neural
- Introdução à Teoria de Treinamento para Redes Neurais
- Entendendo Taxa de Aprendizado em Redes Neurais
- Machine Learning Avançado com Perceptron Multicamada
- Função de Ativação Sigmoid: Ativação em Perceptrons Multicamadas
- Como Treinar um Perceptron Multicamada
- Entendendo Fórmulas de Treinamento e Backpropagation para Perceptrons Multicamadas
- Arquitetura de Rede Neural para Implementação Python
- Como Criar um Perceptron Multicamada em Python
- Processamento de Sinais Usando Redes Neurais: Validação no Design de Redes Neurais
- Datasets de Treinamento para Redes Neurais: Como Treinar e Validar uma Rede Neural Python
- Quantas Camadas e Nós Ocultos uma Rede Neural Precisa?
- Como Aumentar a Precisão de uma Rede Neural com Camada Oculta
O número de nós em uma camada oculta influencia diretamente precisão de classificação e velocidade de treino. Nossos experimentos fornecerão intuição baseada em dados para selecionar tamanho de camada oculta que equilibre velocidade, latência e precisão.
Benchmark em Python
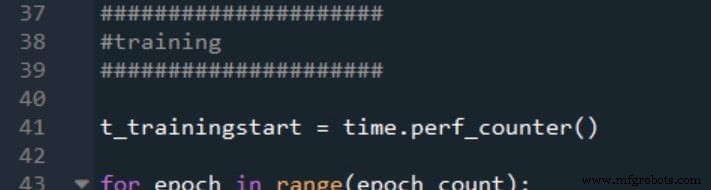
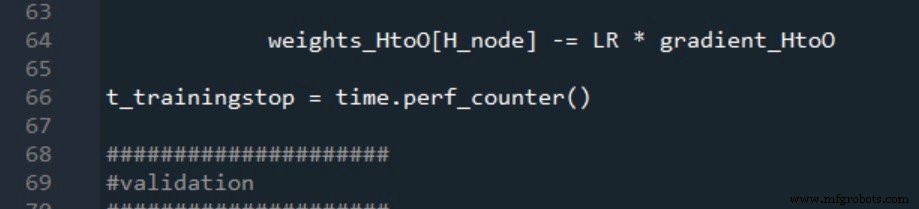
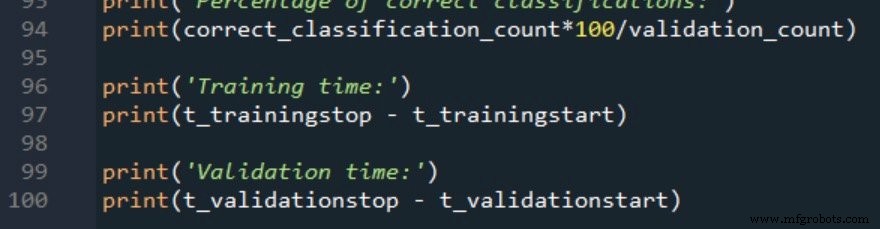
Aumentaremos o código Python existente da Parte 12 para registrar durações de treino e validação usando time.perf_counter(). Abaixo está a instrumentação de tempo:
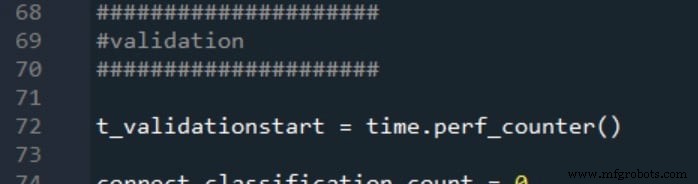
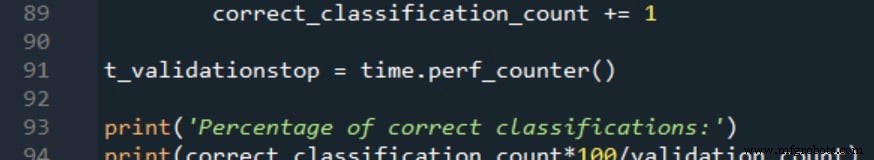
Tempo de validação segue o mesmo padrão:
Os resultados são reportados como:
Dados de Treino e Procedimento de Medição
Testamos uma tarefa de classificação binária usando quatro entradas numéricas variando de –20 a +20. A arquitetura da rede é 4 nós de entrada, uma única camada oculta e um nó de saída. Valores de entrada são gerados com a fórmula Excel mostrada abaixo:
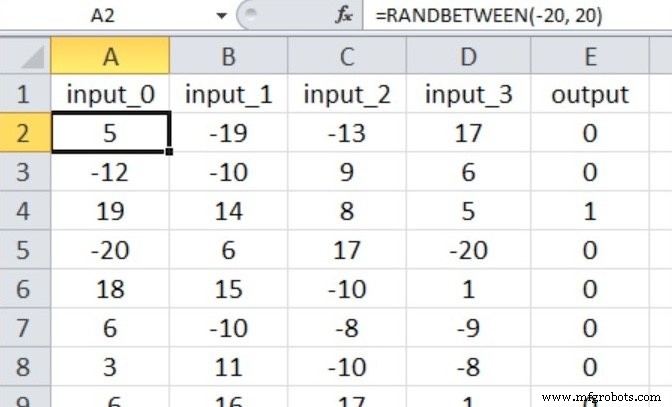
Tamanhos de dataset: 40.000 amostras de treino e 5.000 de validação. Usamos taxa de aprendizado 0.1 e realizamos uma época completa por execução. Cada dimensão de camada oculta é testada cinco vezes; a precisão e tempo reportados são médias aritméticas.
Experimento 1: Problema de Baixa Complexidade
O alvo é verdadeiro apenas quando as três primeiras entradas excedem zero; a quarta entrada é irrelevante:
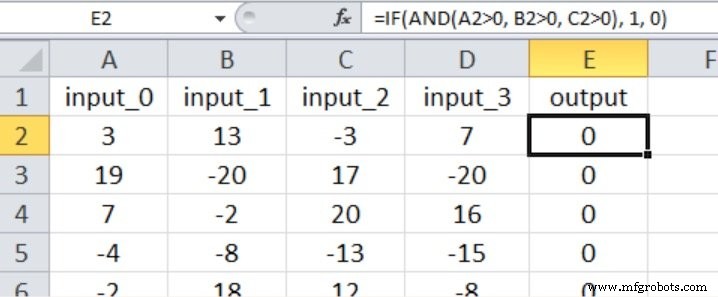
Seguindo a diretriz de dois-terços do tamanho de entrada, começamos com H_dim = 2. Resultados são resumidos abaixo:
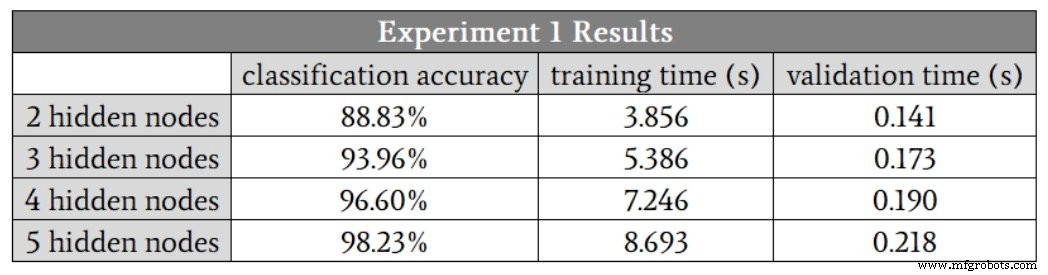
A precisão melhora até cinco nós ocultos, mas o ganho marginal de quatro para cinco nós é modesto porque uma execução com quatro nós foi outlier (88,6%). Removendo esse outlier, quatro nós superam levemente cinco. Tempo de treino sobe 1,9× de dois para quatro nós, enquanto tempo de validação aumenta apenas 1,3×, sublinhando que treino é a fase mais intensiva computacionalmente.
Experimento 2: Problema de Complexidade Moderada
Todas as quatro entradas influenciam a saída, com comparações mais sutis:
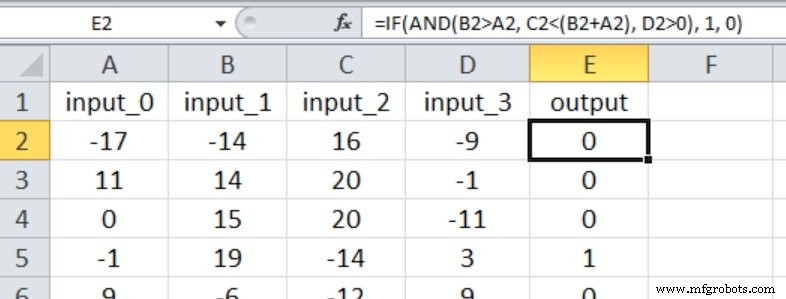
Começando com três nós ocultos, os resultados são:
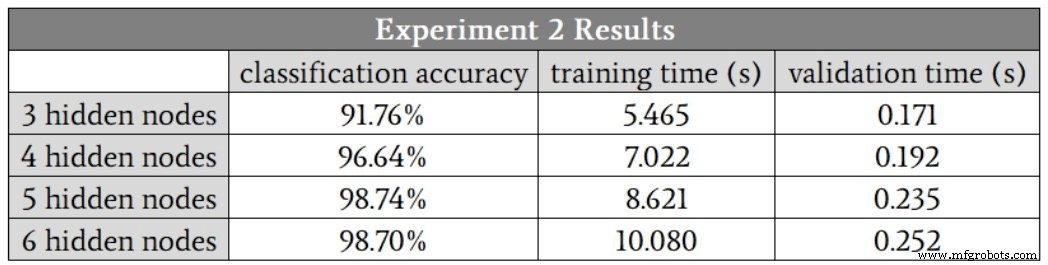
Aqui, cinco nós ocultos parecem ótimos, equilibrando precisão e velocidade. Diferente do Experimento 1, execuções com cinco e seis nós não mostram outliers de baixa precisão, sugerindo que camadas ocultas maiores conferem robustez contra variância de treino.
Experimento 3: Problema de Alta Complexidade
Este cenário introduz não-linearidade: uma entrada é elevada ao quadrado, outra tem raiz quadrada:
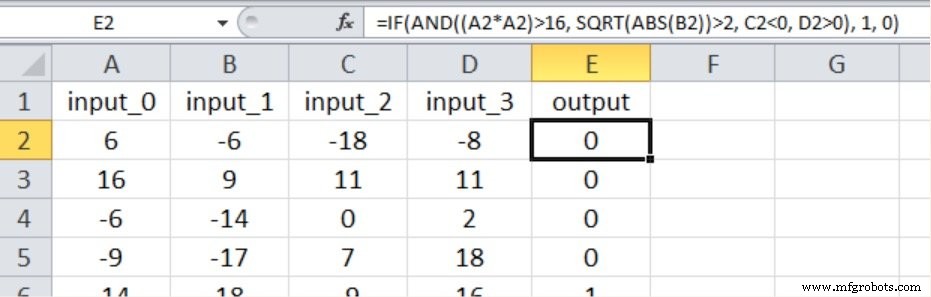
Resultados são os seguintes:
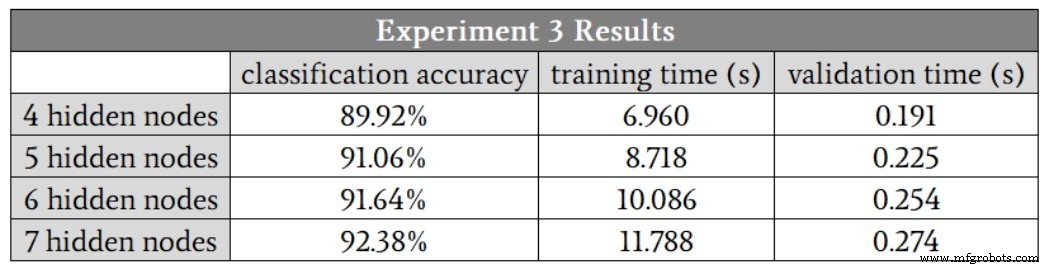
A precisão cai comparado a tarefas de menor complexidade, mesmo com sete nós ocultos. Melhorias como adicionar termo de bias ou annealing da taxa de aprendizado poderiam melhorar desempenho, mas até tais mudanças serem validadas, camada oculta de sete nós é recomendada.
Conclusão
Estes experimentos ilustram trade-off claro: aumentar dimensionalidade da camada oculta geralmente aumenta precisão e estabilidade mas ao custo de tempos de treino mais longos. Use os insights baseados em dados aqui para informar suas escolhas de design ao construir classificadores baseados em Perceptron.
Robô industrial
- Escolhendo o Número Certo de Camadas e Nós Ocultos em Rede Neural
- Treinando Redes Neurais com Excel: Construindo e Validando Perceptron Multicamada em Python
- Construindo Perceptron Multicamada em Python: Guia Prático
- Projetando Perceptron Flexível em Python: Arquitetura, Bias e Ativação
- Treinando Seu Perceptron Multicamada: Estratégias Comprovadas para Performance Ótima
- Como Redes Conectadas Estão Revolucionando a Agricultura Moderna
- Protegendo a IoT do Hardware à Aplicação: Um Blueprint Camada por Camada
- Thomas WebTrax vs. Google Analytics e Thomas Network: Qual Ferramenta Impulsiona Seus Leads Industriais?
- Como Sensores de Rede 0G Protegem Cadeias de Frio de Vacinas
- Escolhendo o Sistema de Corte a Laser Ideal: Aumente Produtividade e Precisão