



Escolhendo o Número Certo de Camadas e Nós Ocultos em Rede Neural
Este artigo oferece diretrizes baseadas em evidências para configurar a porção oculta de um Perceptron multicamada.
Em posts anteriores desta série cobrimos redes Perceptron, arquiteturas multicamadas e implementações Python práticas. Antes de decidir sobre profundidade e largura de suas camadas ocultas, você pode querer revisar os artigos fundamentais listados abaixo.
- Como Realizar Classificação Usando Rede Neural: O Que é o Perceptron?
- Como Usar Exemplo Simples de Perceptron para Classificar Dados
- Como Treinar um Perceptron Básico
- Entendendo Treinamento Simples de Rede Neural
- Introdução à Teoria de Treinamento para Redes Neurais
- Entendendo Taxa de Aprendizado em Redes Neurais
- Machine Learning Avançado com Perceptron Multicamada
- Função de Ativação Sigmoid: Ativação em Perceptrons Multicamadas
- Como Treinar um Perceptron Multicamada
- Entendendo Fórmulas de Treinamento e Backpropagation para Perceptrons Multicamadas
- Arquitetura de Rede Neural para Implementação Python
- Como Criar um Perceptron Multicamada em Python
- Processamento de Sinais Usando Redes Neurais: Validação no Design de Redes Neurais
- Datasets de Treinamento para Redes Neurais: Como Treinar e Validar uma Rede Neural Python
- Escolhendo o Número Certo de Camadas e Nós Ocultos em Rede Neural
Resumo de Camadas Ocultas
Vamos revisar pontos-chave sobre nós ocultos:
- Perceptrons de camada única — redes que contêm apenas nós de entrada e saída — são limitados a problemas linearmente separáveis. Eles não podem modelar relações complexas como a função booleana XOR.
- Introduzir uma camada oculta transforma o Perceptron em um aproximador universal, permitindo aprender virtualmente qualquer mapeamento contínuo entre espaços de entrada e saída finitos.
- Pesos oculto-para-saída influenciam o erro final indiretamente, tornando o treinamento mais intrincado.
- Backpropagation é o método de treinamento padrão: o erro é propagado para trás através da rede, permitindo atualizar todos os pesos não-de-saída, independentemente do número de camadas ocultas.
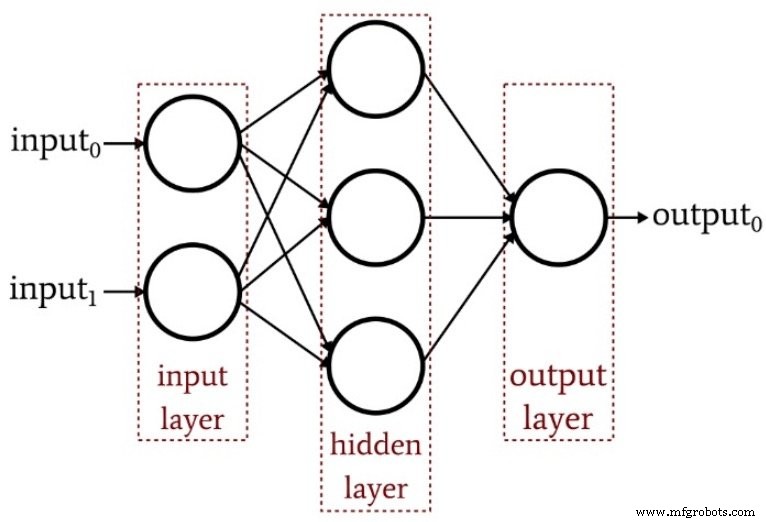
O diagrama abaixo ilustra a estrutura básica de um Perceptron multicamada.
Quantas Camadas Ocultas?
Não há resposta única para todos. No entanto, uma única camada oculta já dota a rede de poder expressivo notável. Se desempenho for insatisfatório, considere ajustar taxa de aprendizado, estender épocas de treino ou enriquecer o conjunto de treino antes de adicionar profundidade.
Adicionar segunda camada oculta aumenta complexidade do código e tempo de inferência, e pode exacerbar overfitting — especialmente quando dados de treino são limitados.
Overfitting ocorre quando a rede memoriza idiossincrasias do conjunto de treino em vez de aprender um mapeamento generalizável. O diagrama a seguir visualiza este fenômeno.
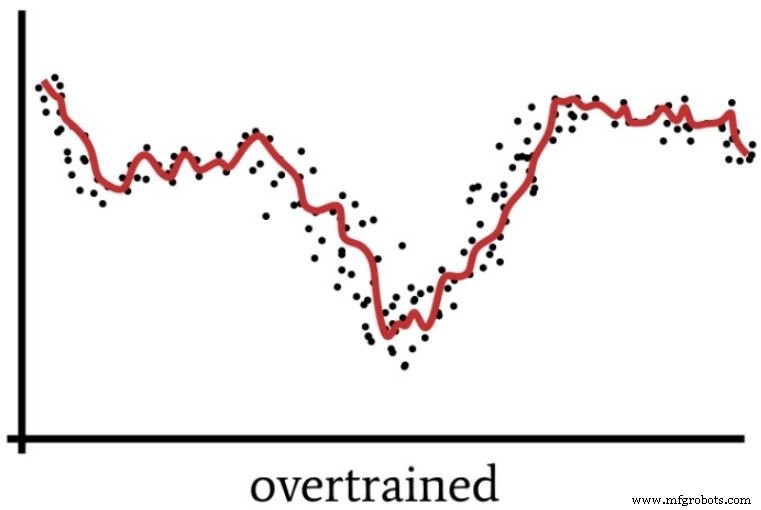
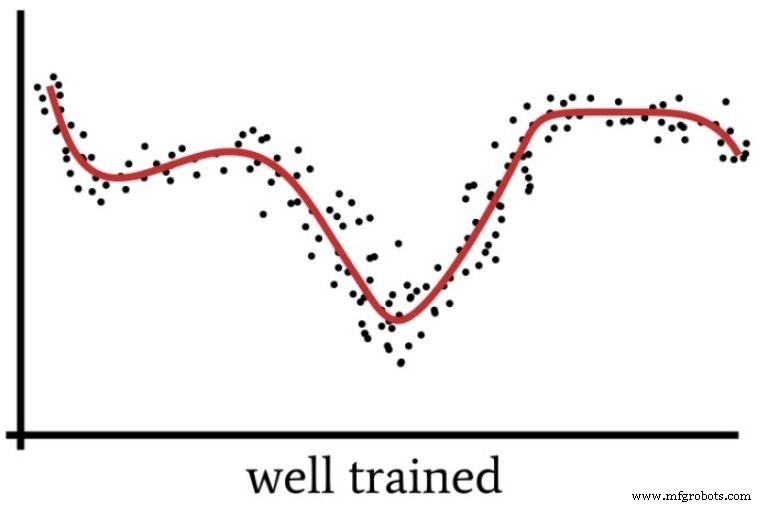
Uma rede altamente parametrizada pode "pensar demais" um problema, produzindo solução que funciona bem em dados de treino mas mal em amostras não vistas. A figura subsequente mostra como capacidade excessiva pode prejudicar generalização.
Quando uma camada oculta extra é justificada? Dr. Jeff Heaton, em seu livro abrangente sobre treinamento de redes neurais, nota que uma única camada oculta pode aproximar qualquer função contínua entre espaços finitos. Adicionar segunda camada permite que a rede represente fronteiras de decisão com precisão arbitrária, mas apenas quando a complexidade do problema realmente justifica.
Quantos Nós Ocultos?
Escolher o número certo de nós por camada oculta é equilíbrio entre expressividade e risco de overfitting. Embora experimentação seja essencial, Dr. Heaton fornece três heurísticas práticas (p. 159) que servem como ponto de partida sólido. Baseado em experiência em processamento de sinal, sugiro as seguintes diretrizes:
- Se a rede tem único nó de saída e o mapeamento é relativamente simples, defina dimensionalidade oculta para dois-terços da dimensionalidade de entrada.
- Se há múltiplas saídas ou a relação é complexa, use tamanho oculto igual à soma de dimensões de entrada e saída — mantendo-o abaixo do dobro do tamanho de entrada.
- Para mapeamentos extremamente intrincados, defina tamanho oculto para um menos que o dobro da dimensionalidade de entrada.
Conclusão
Seguindo estes princípios, você pode configurar e refinar sistematicamente as camadas ocultas de um Perceptron multicamada para alcançar desempenho robusto. No próximo artigo demonstraremos como estas regras se traduzem em código Python concreto e avaliaremos seu impacto em datasets reais.
Robô industrial
- O Que é uma Prensa de Alternância? Como Funciona e Por Que Importa
- Como Operam Prensas de Cremalheira e Pinhão: Guia Prático
- Moldagem por Transferência Explicada: Processo, Benefícios e Variantes
- Entendendo Transmissões de Veículos: Tipos, Funções e Como Operam
- Adicionando Nós de Bias a Perceptron Multicamada em Python
- Otimizando Tamanho da Camada Oculta para Aumentar Precisão de Rede Neural
- Treinando Redes Neurais com Excel: Construindo e Validando Perceptron Multicamada em Python
- Construindo Perceptron Multicamada em Python: Guia Prático
- Entendendo Embreagens Industriais: Definição, Função e Aplicações
- Como Determinar a Potência Necessária para a sua Bomba Hidráulica