



Entendendo o Hadoop: Guia para Processamento de Big Data
A evolução do big data produziu novos desafios que exigiram novas soluções. Como nunca antes na história, servidores precisam processar, ordenar e armazenar quantidades massivas de dados em tempo real.
Esse desafio levou ao surgimento de novas plataformas, como o Apache Hadoop, que consegue lidar com grandes conjuntos de dados com facilidade.
Neste artigo, você aprenderá o que é o Hadoop, quais são seus principais componentes e como o Apache Hadoop auxilia no processamento de big data.
O que é Hadoop?
A biblioteca de software Apache Hadoop é um framework open-source que permite gerenciar e processar big data eficientemente em um ambiente de computação distribuída.
O Apache Hadoop consiste em quatro módulos principais:
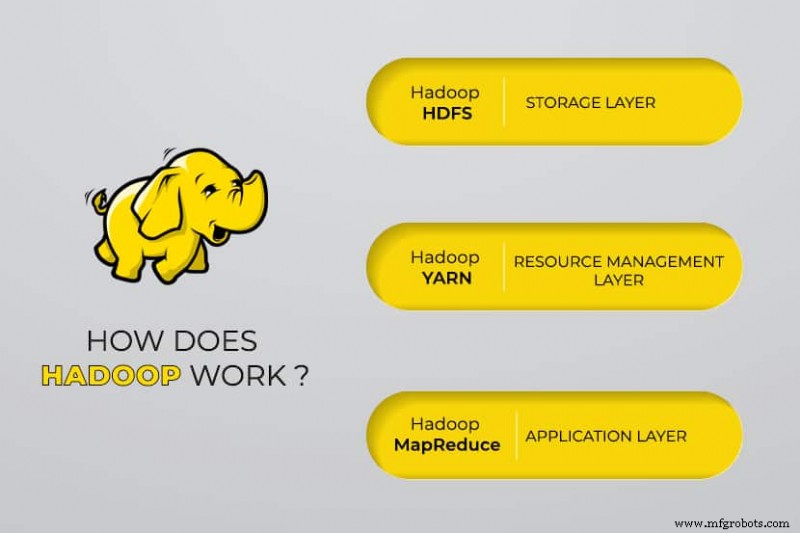
Hadoop Distributed File System (HDFS)
Os dados residem no Sistema de Arquivos Distribuído do Hadoop, semelhante ao de um sistema de arquivos local em um computador comum. O HDFS oferece melhor throughput de dados comparado a sistemas de arquivos tradicionais.
Além disso, o HDFS proporciona excelente escalabilidade. Você pode escalar de uma única máquina para milhares com facilidade e em hardware commodity.
Yet Another Resource Negotiator (YARN)
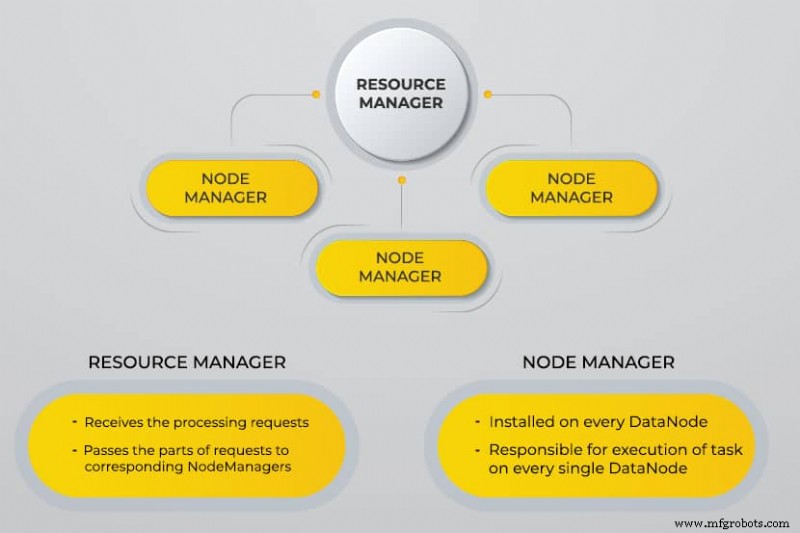
O YARN facilita o agendamento de tarefas, gerenciando e monitorando nós do cluster e outros recursos.
MapReduce
O módulo Hadoop MapReduce ajuda programas a realizar computação paralela de dados. A tarefa Map do MapReduce converte os dados de entrada em pares chave-valor. As tarefas Reduce consomem a entrada, agregam-na e produzem o resultado.
Hadoop Common
O Hadoop Common utiliza bibliotecas Java padrão em todos os módulos.
Por que o Hadoop foi Desenvolvido?
A World Wide Web cresceu exponencialmente na última década e agora consiste em bilhões de páginas. Buscar informações online tornou-se difícil devido à sua quantidade significativa. Esses dados tornaram-se big data e consistem em dois problemas principais:
- Dificuldade em armazenar todos esses dados de forma eficiente e fácil de recuperar
- Dificuldade em processar os dados armazenados
Desenvolvedores trabalharam em muitos projetos open-source para retornar resultados de busca web mais rápidos e eficientes, abordando os problemas acima. A solução foi distribuir dados e cálculos em um cluster de servidores para alcançar processamento simultâneo.
Eventualmente, o Hadoop surgiu como solução para esses problemas e trouxe muitos outros benefícios, incluindo a redução de custos de implantação de servidores.
Como Funciona o Processamento de Big Data com Hadoop?
Usando o Hadoop, utilizamos a capacidade de armazenamento e processamento de clusters e implementamos processamento distribuído para big data. Essencialmente, o Hadoop fornece uma base sobre a qual você constrói outras aplicações para processar big data.
Aplicações que coletam dados em diferentes formatos os armazenam no cluster Hadoop via API do Hadoop, que se conecta ao NameNode. O NameNode captura a estrutura do diretório de arquivos e a colocação de "chunks" para cada arquivo criado. O Hadoop replica esses chunks entre DataNodes para processamento paralelo.
O MapReduce realiza a consulta de dados. Ele mapeia todos os DataNodes e reduz as tarefas relacionadas aos dados no HDFS. O próprio nome "MapReduce" descreve o que faz: tarefas Map executam em cada nó para os arquivos de entrada fornecidos, enquanto reducers executam para vincular os dados e organizar a saída final.
Ferramentas de Big Data do Hadoop
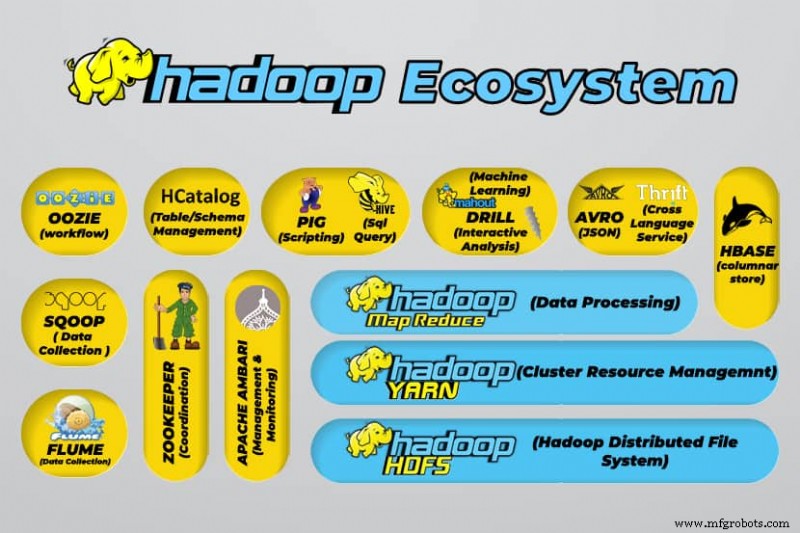
O ecossistema do Hadoop suporta uma variedade de ferramentas open-source de big data. Essas ferramentas complementam os componentes centrais do Hadoop e aprimoram sua capacidade de processar big data.
As ferramentas mais úteis para processamento de big data incluem:
- Apache Hive
O Apache Hive é um data warehouse para processar grandes conjuntos de dados armazenados no sistema de arquivos do Hadoop.
- Apache Zookeeper
O Apache Zookeeper automatiza failovers e reduz o impacto de um NameNode com falha.
- Apache HBase
O Apache HBase é um banco de dados não-relacional open-source para Hadoop.
- Apache Flume
O Apache Flume é um serviço distribuído para streaming de grandes quantidades de dados de log.
- Apache Sqoop
O Apache Sqoop é uma ferramenta de linha de comando para migrar dados entre Hadoop e bancos de dados relacionais.
- Apache Pig
O Apache Pig é a plataforma de desenvolvimento do Apache para criar jobs que rodam no Hadoop. A linguagem usada é Pig Latin.
- Apache Oozie
O Apache Oozie é um sistema de agendamento que facilita o gerenciamento de jobs do Hadoop.
- Apache HCatalog
O Apache HCatalog é uma ferramenta de gerenciamento de armazenamento e tabelas para ordenar dados de diferentes ferramentas de processamento.
Vantagens do Hadoop
O Hadoop é uma solução robusta para processamento de big data e uma ferramenta essencial para empresas que lidam com big data.
Os principais recursos e vantagens do Hadoop são detalhados abaixo:
- Armazenamento e processamento mais rápidos de grandes volumes de dados
A quantidade de dados a ser armazenada aumentou dramaticamente com a chegada das redes sociais e da Internet das Coisas (IoT). Armazenamento e processamento desses conjuntos de dados são críticos para as empresas que os possuem. - Flexibilidade
A flexibilidade do Hadoop permite salvar tipos de dados não estruturados como texto, símbolos, imagens e vídeos. Em bancos de dados relacionais tradicionais como RDBMS, você precisa processar os dados antes de armazená-los. Com o Hadoop, o pré-processamento não é necessário; você armazena os dados como são e decide como processá-los depois. Em outras palavras, comporta-se como um banco de dados NoSQL. - Poder de processamento
O Hadoop processa big data através de um modelo de computação distribuída. Seu uso eficiente do poder de processamento o torna rápido e eficiente. - Custo reduzido
Muitas equipes abandonavam seus projetos antes da chegada de frameworks como o Hadoop, devido aos altos custos. O Hadoop é um framework open-source, gratuito para uso, e utiliza hardware commodity barato para armazenar dados. - Escalabilidade
O Hadoop permite escalar seu sistema rapidamente sem muita administração, apenas alterando o número de nós em um cluster. - Tolerância a falhas
Uma das muitas vantagens de usar um modelo de dados distribuído é sua capacidade de tolerar falhas. O Hadoop não depende de hardware para manter disponibilidade. Se um dispositivo falha, o sistema redireciona automaticamente a tarefa para outro dispositivo. A tolerância a falhas é possível porque dados redundantes são mantidos salvando múltiplas cópias dos dados pelo cluster. Em outras palavras, alta disponibilidade é mantida na camada de software.
Os Três Principais Casos de Uso
Processamento de big data
Recomendamos o Hadoop para quantidades massivas de dados, geralmente na faixa de petabytes ou mais. É mais adequado para enormes volumes de dados que exigem enorme poder de processamento. O Hadoop pode não ser a melhor opção para organizações que processam quantidades menores, na faixa de algumas centenas de gigabytes.
Armazenamento de conjunto diversificado de dados
Uma das muitas vantagens do Hadoop é sua flexibilidade e suporte a vários tipos de dados. Independentemente de os dados consistirem em texto, imagens ou vídeo, o Hadoop os armazena eficientemente. As organizações podem escolher como processar os dados conforme sua necessidade. O Hadoop tem características de data lake, pois oferece flexibilidade sobre os dados armazenados.
Processamento paralelo de dados
O algoritmo MapReduce usado no Hadoop orquestra o processamento paralelo de dados armazenados, significando que você pode executar várias tarefas simultaneamente. Porém, operações conjuntas não são permitidas, pois confundem a metodologia padrão no Hadoop. Ele incorpora paralelismo enquanto os dados forem independentes entre si.
Para que o Hadoop é Usado no Mundo Real
Empresas ao redor do mundo usam sistemas de processamento de big data Hadoop. Alguns dos muitos usos práticos do Hadoop estão listados abaixo:
- Entender requisitos dos clientes
Atualmente, o Hadoop provou ser muito útil para entender requisitos dos clientes. Grandes empresas do setor financeiro e de mídia social usam essa tecnologia para analisar big data sobre suas atividades.
Empresas usam esses dados para oferecer ofertas personalizadas aos clientes. Você pode ter experimentado isso através de anúncios exibidos em redes sociais e sites de e-commerce baseados em nossos interesses e atividade na internet. - Otimizar processos de negócio
O Hadoop ajuda a otimizar o desempenho dos negócios analisando melhor dados de transações e clientes. Análise de tendências e análise preditiva ajudam empresas a personalizar produtos e estoques para aumentar vendas. Tal análise facilita a tomada de decisões e leva a maiores lucros.
Além disso, empresas usam Hadoop para melhorar o ambiente de trabalho monitorando comportamento dos funcionários coletando dados sobre suas interações. - Melhorar serviços de saúde
Instituições do setor médico podem usar Hadoop para monitorar a vasta quantidade de dados sobre questões de saúde e resultados de tratamentos. Pesquisadores podem analisar esses dados para identificar problemas de saúde, prever medicação e decidir planos de tratamento. Tais melhorias permitirão que países melhorem rapidamente seus serviços de saúde. - Trading financeiro
O Hadoop possui algoritmo sofisticado para escanear dados de mercado com configurações predefinidas para identificar oportunidades de trading e tendências sazonais. Empresas financeiras podem automatizar a maioria dessas operações através das robustas capacidades do Hadoop. - Usando Hadoop para IoT
Dispositivos IoT dependem da disponibilidade de dados para funcionar eficientemente. Fabricantes e inventores usam Hadoop como data warehouse para bilhões de transações. Como IoT é um conceito de streaming de dados, o Hadoop é uma solução adequada e prática para gerenciar as vastas quantidades de dados que abrange.
O Hadoop é atualizado continuamente, permitindo melhorar as instruções usadas com plataformas IoT.
Outros usos práticos do Hadoop incluem melhorar desempenho de dispositivos, quantificação pessoal e otimização de performance, melhorar pesquisas esportivas e científicas.
Quais são os Desafios de Usar o Hadoop?
Toda aplicação vem com vantagens e desafios. O Hadoop também introduz vários desafios:
- O algoritmo MapReduce nem sempre é a solução
O algoritmo MapReduce não suporta todos os cenários. É adequado para requisições simples de informação e problemas que podem ser divididos em unidades independentes, mas não para tarefas iterativas.
MapReduce é ineficiente para computação analítica avançada, pois algoritmos iterativos requerem intensa intercomunicação e criam múltiplos arquivos na fase MapReduce. - Gerenciamento de dados completamente desenvolvido
O Hadoop não fornece ferramentas abrangentes para gerenciamento de dados, metadados e governança de dados. Além disso, carece de ferramentas para padronização de dados e determinação de qualidade. - Lacuna de talentos
Devido à curva de aprendizado íngreme do Hadoop, pode ser difícil encontrar programadores iniciantes com habilidades em Java suficientes para serem produtivos com MapReduce. Essa intensidade é a principal razão pela qual provedores se interessam em colocar tecnologia de banco de dados relacional (SQL) sobre o Hadoop, pois é muito mais fácil encontrar programadores com sólido conhecimento em SQL do que habilidades em MapReduce.
A administração do Hadoop é tanto uma arte quanto uma ciência, exigindo conhecimento de baixo nível de sistemas operacionais, hardware e configurações do kernel do Hadoop. - Segurança de dados
O protocolo de autenticação Kerberos é um passo significativo para tornar ambientes Hadoop seguros. A segurança de dados é crítica para proteger sistemas de big data de questões fragmentadas de segurança de dados.
Conclusão
O Hadoop é altamente eficaz no processamento de big data quando implementado eficazmente com as etapas necessárias para superar seus desafios. É uma ferramenta versátil para empresas que lidam com extensas quantidades de dados.
Uma de suas principais vantagens é poder rodar em qualquer hardware e um cluster Hadoop pode ser distribuído entre milhares de servidores. Tal flexibilidade é particularmente significativa em ambientes de infrastructure-as-code.
Computação em Nuvem
- Aproveitando Big Data com Computação em Nuvem: Uma Vantagem Estratégica
- Entendendo Segurança na Nuvem: Por Que Seu Negócio Precisa Disso
- Big Data e Computação em Nuvem: Como Eles Trabalham Juntos
- Alavancando Big Data e Computação em Nuvem para Impulsionar Crescimento de Negócios
- Tendências Emergentes em Plataformas IoT para 2018: Edge Computing, Blockchain e Mais
- Manutenção Preditiva: Desbloqueando Eficiência e Redução de Riscos com Insights Baseados em Dados
- RAM DDR5 Explicada: Recursos, Benefícios e Disponibilidade
- Internet Industrial das Coisas (IIoT): Definição, Escopo e Impacto Industrial
- Big Data vs IA: Sinergia Por Trás da Transformação Digital
- Transformando Pequenos Dados em Insights de Big Data para Manufatura