



Como Processamento Avançado de Sinal Permite Interação Fluida com Assistentes de Voz
Smart speakers e dispositivos controlados por voz estão expandindo rapidamente seu alcance, com assistentes como Alexa da Amazon e Google Assistant melhorando na decifração de nossos comandos falados a cada atualização.
Um dos maiores atrativos desta interface é sua natureza effortless — sem curva de aprendizado, apenas conversa natural. Por trás dessa experiência suave está uma cadeia sofisticada de passos de processamento de sinal que transformam áudio bruto em uma requisição clara e acionável.
Neste artigo examinamos a arquitetura que alimenta soluções controladas por voz, revelando as camadas ocultas de hardware e software que as trazem à vida.
Fluxo de sinal e arquitetura
Embora os detalhes variem entre produtos, o fluxo fundamental é consistente. Usando um smart speaker como Amazon Echo como exemplo, os subsistemas chave são ilustrados na Figura 1.
clique para imagem maior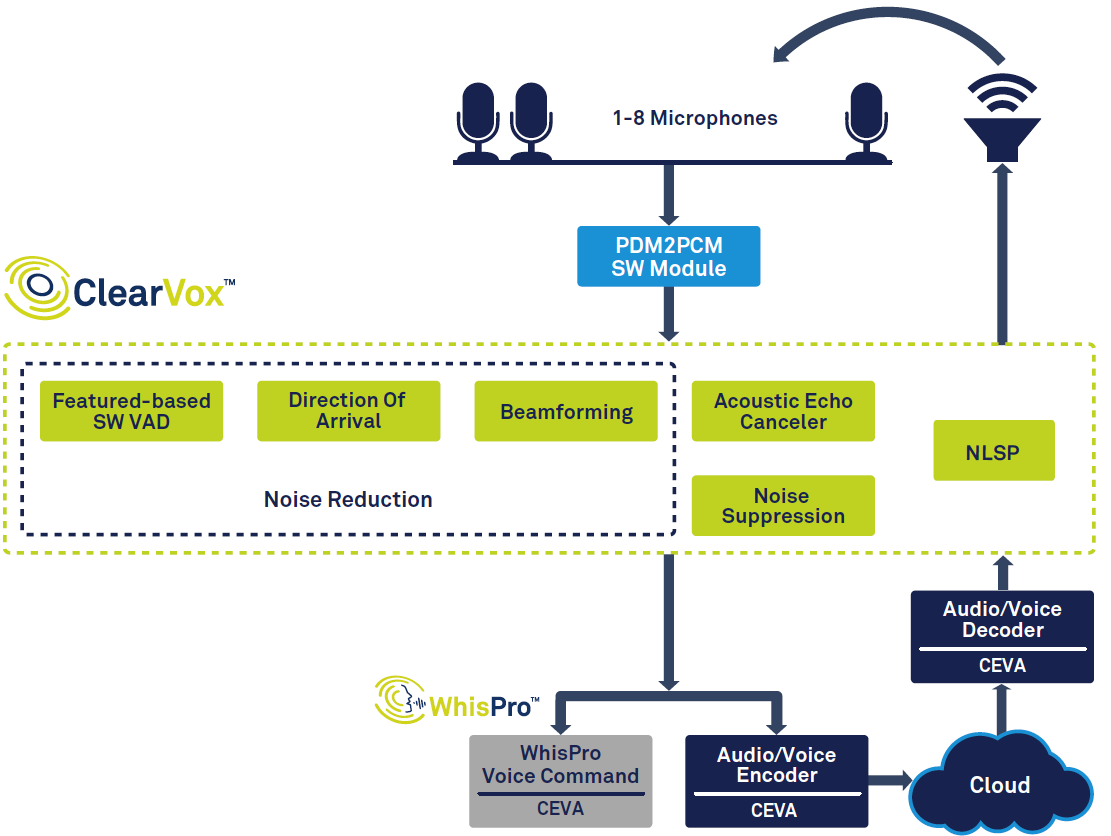
Figura 1: Cadeia de sinal para assistente de voz, baseada no ClearVox e WhisPro da CEVA. (Fonte: CEVA)
A cadeia começa com detecção de atividade de voz (VAD), que isola segmentos falados. O áudio capturado é digitalizado e submetido a uma série de algoritmos de front-end que melhoram clareza focando na direção de chegada do usuário. O sinal processado é então encaminhado para processamento de fala de back-end, que pode rodar parcialmente no dispositivo (edge) e parcialmente na nuvem. Finalmente, uma resposta — texto ou fala — é sintetizada, decodificada e renderizada através do caminho digital-para-analógico do speaker.
Diferentes casos de uso introduzem variações. Por exemplo, interfaces de voz veiculares devem lidar com ruído de estrada, enquanto wearables emergentes demandam ultra-baixa potência e custo mínimo.
Processamento de sinal de front-end
Após VAD e digitalização, o dispositivo deve suprimir sons indesejados. Cancelamento de eco acústico (AEC) remove reflexos causados pela própria reprodução do dispositivo, permitindo "barge-in" seamless mesmo enquanto música toca. Supressão de ruído então limpa ruído de fundo residual.
Dispositivos controlados por voz se enquadram em duas categorias: near-field (headsets, earbuds) e far-field (smart speakers, TVs). Unidades near-field tipicamente usam um ou dois microfones, enquanto unidades far-field deploy três a oito mics. Estas últimas enfrentam ambiente acústico mais severo — vozes somem com distância, ruído de fundo permanece constante, e reverberação complica extração de sinal.
Unidades far-field empregam beamforming, técnica que calcula direção da fonte a partir de diferenças de tempo entre microfones. Isso permite ao sistema focar no usuário, ignorar reflexos, rastrear movimento e isolar um único falante quando múltiplas vozes estão presentes.
Detecção de trigger-word (ex: "Alexa") é recurso crítico. Escuta contínua levanta preocupações de privacidade; portanto, muitos sistemas realizam reconhecimento de wake-word localmente, enviando áudio para a nuvem apenas após um comando completo ser detectado.
A amostra de voz limpa é codificada antes da transmissão para o backend na nuvem para análise mais profunda.
Soluções especializadas
Processamento de front-end deve ser rápido, preciso e eficiente em potência — especialmente para wearables alimentados por bateria. DSPs de propósito geral ou CPUs lutam para atender estas demandas em termos de custo, tamanho e consumo de energia. A solução é um DSP application-specific projetado para tarefas de áudio.
ClearVox da CEVA é uma suíte de software que lida com beamforming multi-mic, estimativa de direção de chegada, supressão de ruído e AEC através de cenários acústicos diversos. Otimizado para DSPs de som CEVA, ClearVox entrega caminho de baixo custo e baixa potência para captura de voz de alta qualidade.
Detecção de trigger-word é manejada pelo WhisPro da CEVA, um reconhecedor baseado em rede neural exclusivo para DSPs CEVA. WhisPro mantém o processador principal dormindo até uma wake-word ser detectada, cortando drasticamente potência geral do sistema enquanto mantém taxa de reconhecimento >95%. Suporta múltiplas frases de trigger e palavras customizadas, fator crítico para satisfação do consumidor.
clique para imagem maior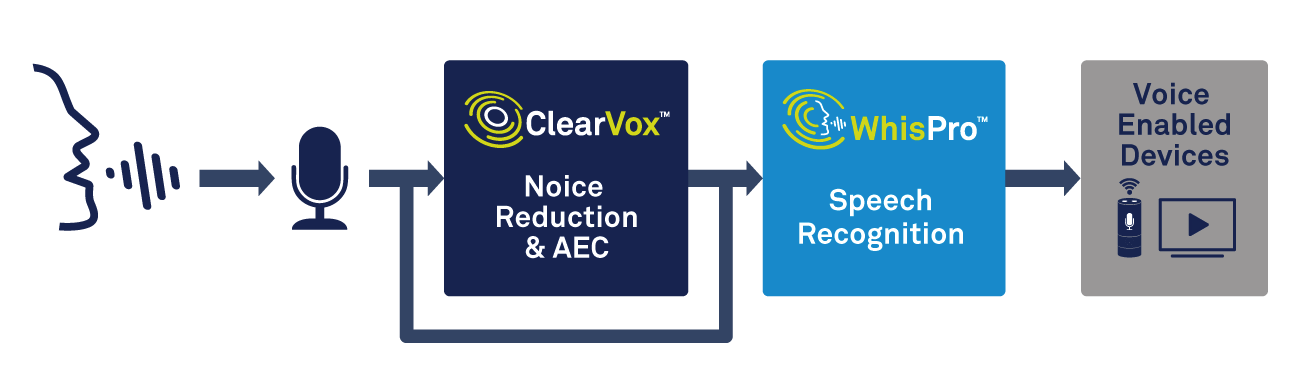
Figura 2: Usando processamento de voz e reconhecimento de fala para ativação por voz. (Fonte: CEVA)
Reconhecimento de fala: local ou nuvem
Uma vez que o áudio está limpo e digitalizado, o próximo passo é automatic speech recognition (ASR). O espectro varia de simples keyword spotting a natural-language processing (NLP) em escala completa. Detecção de palavra-chave é ideal para dispositivos de escopo estreito (ex: termostato inteligente), permitindo respostas offline instantâneas.
Por outro lado, muitas aplicações requerem entendimento contextual. Uma requisição como "Me mostre um hotel bom custo-benefício perto do centro da cidade" deve ser parseada para intent, entities e contexto de follow-up — trabalho que tipicamente demanda inferência de rede neural muito além da capacidade de chips edge de baixa potência.
Processamento baseado em nuvem oferece o poder computacional para entregar NLP sofisticado, ao custo de latência e conexão Internet. Soluções edge estão melhorando, porém; processadores NeuPro AI da CEVA trazem inferência de rede neural on-device para a edge, permitindo respostas locais mais inteligentes e rápidas enquanto ainda recorrem à nuvem quando necessário.
Escolher entre edge e nuvem envolve trade-offs. Processamento local excele em velocidade e privacidade mas luta com queries complexas. Processamento na nuvem escala para NLP complexo mas introduz latência e dependência de conectividade.
Conclusões
Interfaces de voz estão rapidamente se tornando pedra angular da tecnologia cotidiana. Avanços contínuos em processamento de sinal, ASR e IA — acoplados com hardware especializado — estão impulsionando maior precisão, menor potência e custos reduzidos.
OEMs que adotam soluções purpose-built como ClearVox, WhisPro e NeuPro podem atender metas rigorosas de performance, custo e potência enquanto encurtam time-to-market.
À medida que tecnologia de voz amadurece, podemos esperar interação ainda mais natural e horizontes de aplicação mais amplos — uma jornada emocionante que remodelará como nos engajamos com dispositivos.
Integrado
- Como Avanços em Edge AI e Microfones Estão Acelerando a Adoção de Assistentes de Voz
- O Guia Completo da Produção de Fibra de Vidro
- Otimize Sua Cadeia de Suprimentos para Resiliência e Eficiência Hoje
- Como Sistemas SCADA Operam: Monitoramento e Controle de Processos Industriais
- Construa uma Bússola Digital em Tempo Real com Arduino e Processing
- Construa um Protótipo Vencedor: Guia Passo a Passo para Desenvolvimento Rápido de Produto
- Como Secadores de Ar Funcionam: Mantendo Ar Comprimido Limpo e Eficiente
- Grafeno Impresso por Jato de Tinta: O Futuro da Eletrônica Impressa em 3D
- Entendendo Freios Elétricos: Como Funcionam e Por Que São Importantes
- Estratégias Comprovadas para Fazer Seu Programa de Segurança Abrangente Funcionar