



BrainChip Lança Kits de Desenvolvimento Neuromórficos Akida para Edge AI
A BrainChip, provedora líder de IP de computação neuromórfica, introduziu dois novos kits de desenvolvimento com seu SoC neuromórfico Akida na recente Linley Fall Processor Conference. Os kits vêm em formato x86 Shuttle PC e design Raspberry Pi baseado em Arm, dando aos desenvolvedores plataformas prontas para construir e testar aplicações de redes neurais spiking (SNN). O silício Akida também está disponível para integração em designs customizados.
A arquitetura neuromórfica da Akida entrega IA de ultra-baixo consumo imitando o processamento event-driven do cérebro. Diferente de modelos convencionais de deep learning, SNNs transmitem informação através de spikes discretos que codificam tanto padrões espaciais quanto sequências temporais. Este domínio de eventos é ideal para dispositivos edge que requerem inferência em tempo real e consciente de energia a partir de streams de sensores.
Além de workloads nativos SNN, as unidades de processamento neural (NPUs) da BrainChip podem executar redes neurais convolucionais (CNNs) após convertê-las para o domínio de eventos. A conversão, realizada pelo fluxo de software MetaTF, preserva extração de features CNN enquanto habilita aprendizado on-chip através de plasticidade dependente de timing de spike — eliminando necessidade de retreinamento baseado em nuvem.
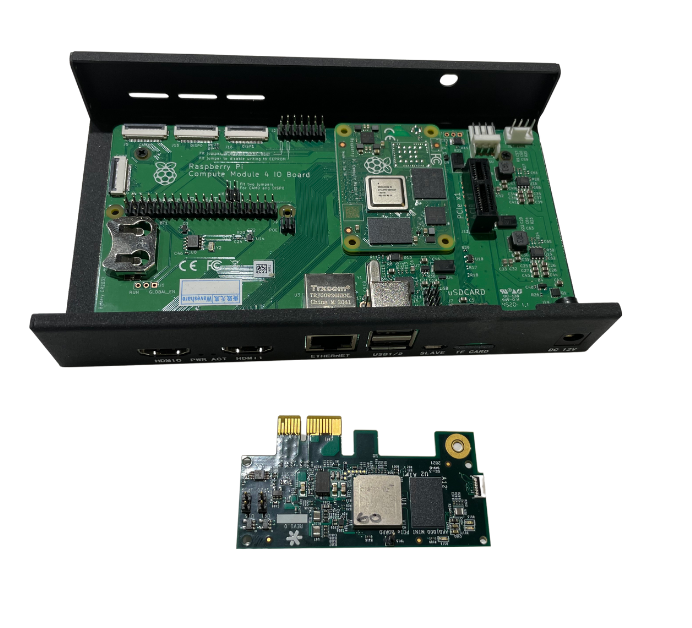
"A Akida está pronta para a tecnologia neuromórfica de amanhã, mas já resolve os desafios de edge AI de hoje", disse Anil Mankar, co-fundador e chief development officer da BrainChip, ao EE Times. "Nosso software de runtime remove a curva de aprendizado em torno de SNNs e do domínio de eventos, permitindo que desenvolvedores familiarizados com TensorFlow ou Keras portem modelos e avaliem potência e acurácia diretamente em nosso hardware."
Mankar explicou que CNNs se destacam em extrair features de grandes datasets. Convertendo camadas CNN para operações baseadas em eventos — exceto a camada final de classificação — a Akida retém essa capacidade enquanto adiciona aprendizado de timing de spike. SNNs nativas podem usar precisão de um bit, enquanto CNNs convertidas tipicamente empregam spikes de 1, 2 ou 4 bits. A ferramenta de quantização da BrainChip ajuda designers a escolher a largura de bit apropriada por camada. Por exemplo, um modelo MobileNet V1 quantizado para 4 bits alcançou 93,1% de acurácia em tarefa de classificação de 10 classes.
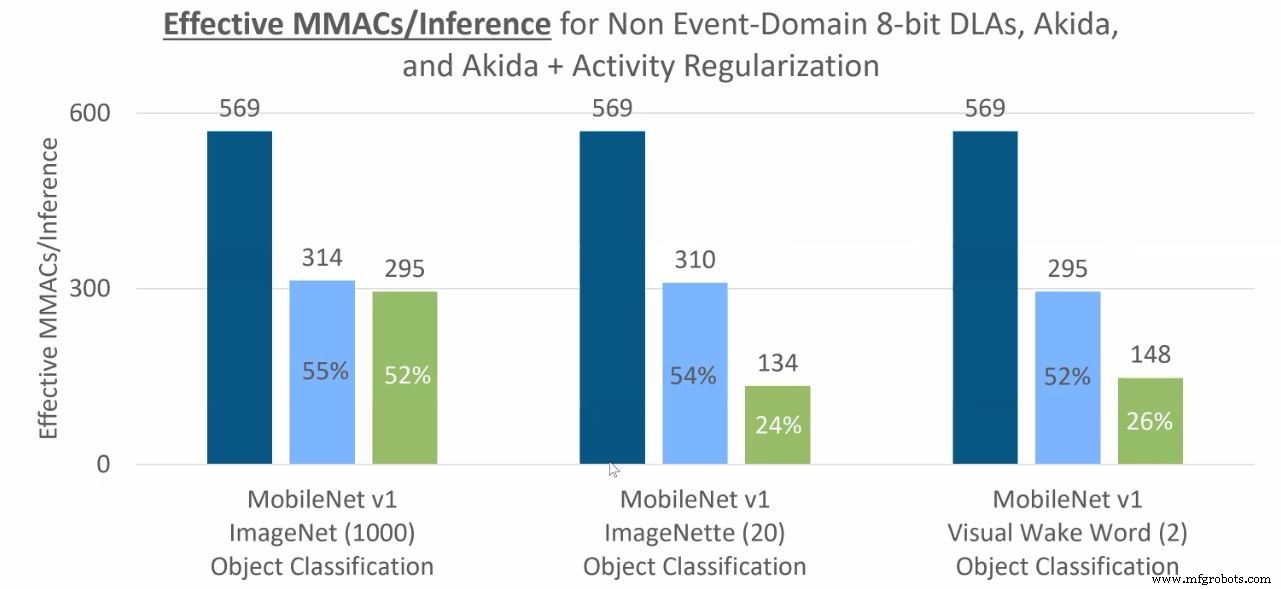
Converter para o domínio de eventos também rende economia significativa de energia devido à esparsidade. No domínio de eventos, apenas valores de ativação não-zero geram spikes, e a NPU processa apenas esses eventos. Para uma CNN típica, aproximadamente metade das ativações são zero após ReLU, então a implementação baseada em eventos reduz dramaticamente o número de operações MAC, baixando consumo de energia.
Funções como convolução, convolução point-wise, depth-wise convolution, max pooling e global average pooling podem todas ser traduzidas para o domínio de eventos. O diagrama a seguir ilustra a redução em operações MAC para uma tarefa de classificação de objetos: azul escuro representa CNN tradicional, azul claro mostra implementação Akida no domínio de eventos, e verde indica regularização de atividade adicional.
Em benchmark real, um modelo de keyword-spotting rodando na placa Akida após quantização de 4 bits consumiu apenas 37 µJ por inferência (equivalente a 27.336 inferências por segundo por watt). O modelo alcançou 91,3% de acurácia operando a um modesto clock de 5 MHz.
Agnóstico a Sensores
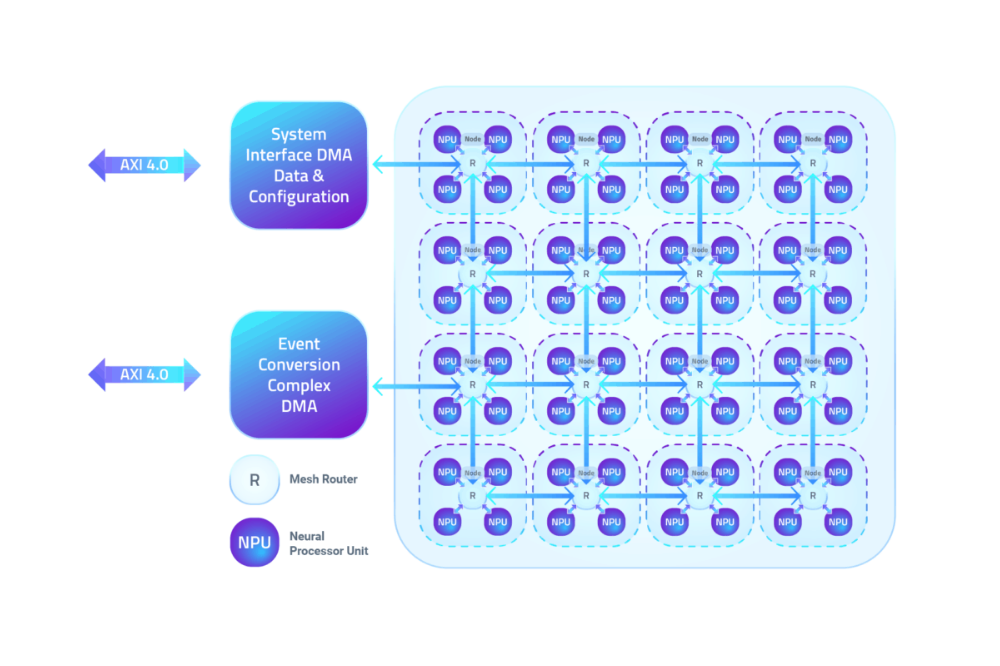
A NPU IP e chip Akida da BrainChip são network-agnostic e suportam ampla gama de sensores. Seja processando imagens, áudio, olfativo, gustativo ou dados táteis, o mesmo hardware lida com tanto CNNs (via conversão) quanto SNNs nativas.
Cada nó NPU contém 100 kB de SRAM local para parâmetros, ativações e buffers de eventos, e até quatro nós podem ser agrupados em rede mesh. Redes abrangendo múltiplos nós comunicam-se diretamente entre camadas sem intervenção da CPU, embora certas workloads non-CNN ainda exijam suporte da CPU. O IP pode escalar para 20 nós, permitindo modelos maiores rodarem em múltiplas passagens em hardware menor.
Um vídeo demo mostrou Akida em cabine de veículo: um chip simultaneamente detectou o motorista, reconheceu o rosto do motorista e identificou sua voz. Keyword spotting requereu apenas 600 µW, reconhecimento facial 22 mW, e inferência visual wake-word 6-8 mW — demonstrando adequação do chip para edge AI automotivo.
Rob Telson, vice-presidente de vendas globais da BrainChip, notou que o processo 28-nm TSMC da Akida fornece baseline forte, e clientes de IP podem migrar para nós mais finos para eficiência energética ainda maior. Ele também destacou aprendizado on-chip para reconhecimento facial: com neurônios suficientes na camada final, um sistema pode crescer de reconhecer 10 rostos para mais de 50 com one-shot learning, eliminando dependência de nuvem.
Clientes de Acesso Antecipado
A BrainChip emprega 55 funcionários entre sua sede em Aliso Viejo, CA, e escritórios de design em Toulouse, França; Hyderabad, Índia; e Perth, Austrália. A empresa detém 14 patentes, negocia na bolsa australiana e está listada no mercado OTC dos EUA.
Clientes de acesso antecipado incluem NASA, automotivo, militar, aeroespacial, médico (ex: detecção olfativa de COVID-19) e empresas de eletrônicos de consumo. A Renesas licenciou NPU Akida de 2 nós para integração em futuras unidades de microcontrolador voltadas para análise de dados de sensores em implantações IoT.
IP e silício Akida estão disponíveis agora.
>> Este artigo foi publicado originalmente em nosso site irmão, EE Times.
Conteúdo Relacionado
- Startup empacota 1000 cores RISC-V em chip acelerador de IA
- Chip de IA visa dispositivos edge de baixo consumo
- SoCs habilitados para IA lidam com múltiplos streams de vídeo
- Construindo segurança em SoC de IA usando features de CPU com extensões
- Arquiteturas de microcontroladores evoluem para IA
Para mais Embedded, assine a newsletter semanal por e-mail do Embedded.
Integrado
- Por Que Linux Alimenta a Nuvem: Um Guia Abrangente
- 10 Benefícios Essenciais da Computação em Nuvem para Empresas Modernas
- Computação em Nuvem vs. On-Premise: Qual Infraestrutura Melhor Atende seu Negócio?
- Grupos de Event Flags no Nucleus SE: Guia Introdutório de Configuração e Uso da API
- Chips Neuromórficos: Próxima Fronteira para Performance IA
- Kontron Revela COM HPC: Novo Padrão de Computação Embarcada de Alto Desempenho
- STMicroelectronics Lança Kits de Desenvolvimento LoRa a $99 para Implantação Rápida de IoT
- Kit de Desenvolvimento RSL10 Mesh Capacita Redes BLE Ultra-Baixo Consumo
- ams Revela Kits NanoVision e NanoBerry Alimentados por Sensor NanEyeC de 1 mm × 1 mm
- Eventos em C#: Manipulando Ações do Usuário e Notificações do Sistema