



Processamento de Documentos Aprimorado: Unindo Técnicas Baseadas em Regras e Modelos para Automação Precisa
Informação é poder. Para a maioria das empresas, muitas informações valiosas de negócios estão presas em documentos. Dada a variedade de tipos, tamanhos e formatos de documentos que as empresas frequentemente gerenciam, processar documentos eficientemente para obter insights pode ser desafiador.
Aqui na UiPath, entendemos este desafio. Graças ao nosso mais novo framework de entendimento de documentos, nossos clientes podem facilmente automatizar extração e processamento de dados para uma ampla gama de documentos, independentemente de seu tipo, formato ou volume. Isso ajuda você a abordar o processamento de documentos com flexibilidade, usando qualquer processo que funcione melhor para suas necessidades únicas.
Para uma visão de alto nível dos benefícios do entendimento de documentos, confira nosso white paper Aumente a Eficiência Operacional e Mitigue Riscos com Document Understanding.
Neste artigo, nós:
Revisaremos tipos e classificações comuns de documentos
Examinaremos métodos de extração de dados baseados em regras e baseados em modelos
Analisaremos os desafios comuns que as empresas enfrentam ao aplicar cada uma dessas abordagens padrão ao processamento de documentos
Revisaremos os benefícios que as empresas podem obter se ambas as abordagens de processamento de documentos forem combinadas como um método de extração de dados multi-abordagem
Vamos começar.
Cenário de documentos
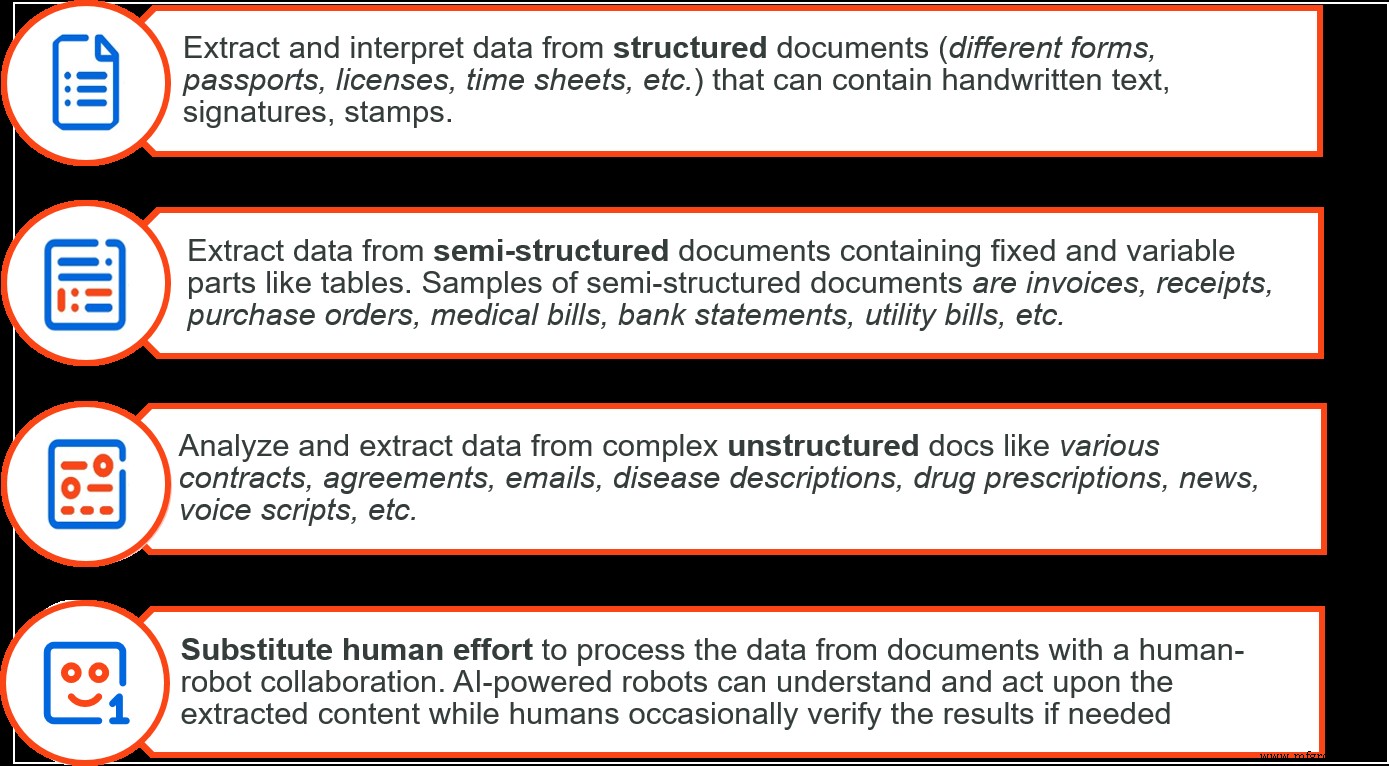
Dependendo de sua estrutura e formato, documentos podem ser classificados em três tipos.
1. Muitos documentos, como formulários de imposto, permanecem fixos em formato — estes são chamados documentos estruturados.
2. Outros, como contratos, não têm estrutura padrão — estes são referidos como documentos não estruturados.
3. Finalmente, documentos que têm qualidades diferentes, como layouts ou designs variados, mas incluem tipos similares de informação, são chamados documentos semi-estruturados. Recibos, faturas e pedidos de compra são exemplos comuns de documentos nesta categoria.
Com base na classificação de documentos, existem dois tipos comuns de metodologias de extração de dados. Extração de dados baseada em regras visa documentos estruturados, enquanto extração de dados baseada em modelos é usada para processar documentos semi-estruturados e não estruturados.
Benefícios e limites dos métodos de extração de dados baseados em regras
Extração de dados baseada em regras depende de um conjunto de regras para extrair dados de um documento. Por exemplo, você pode criar templates de documentos e aplicar regras baseadas em posição específica de dados. Alternativamente, sem ter que criar templates, você pode simplesmente aplicar regras baseadas em quão frequentemente alguns conjuntos de dados são usados em um documento (padrões de ocorrência) ou como essas variáveis de dados geralmente aparecem em uma sequência de caracteres (expressão regular ou regex).
O primeiro é útil ao lidar com formulários que podem ser transformados em templates, e o último é usado se for possível e fácil criar tais regras. Descobrimos que métodos baseados em regras são fáceis de configurar e entender, e funcionam muito eficientemente no processamento de documentos. No entanto, eles são limitados a documentos estruturados e apenas em alguns casos simples a documentos semi-estruturados.
Portanto, embora técnicas de extração de dados baseadas em regras sejam benéficas em muitos contextos, elas têm limitações óbvias de aplicação. Como a extração baseada em templates está intimamente ligada a um layout de documento fixo, quaisquer mudanças no layout podem quebrar as regras e exigir reconfiguração.
Da mesma forma, técnicas baseadas em regex podem ser desafiadoras de implementar, solucionar problemas e complicadas à medida que as situações se tornam mais complexas. No entanto, existe uma abordagem alternativa para soluções de extração baseadas em regras — uma abordagem baseada em modelos.
Benefícios e limites dos métodos de extração de dados baseados em modelos
Metodologias de extração de dados baseadas em modelos são baseadas em machine learning (ML). Esses métodos são poderosos devido à sua capacidade de aprender de um conjunto diversificado de documentos. Usamos esses métodos empregando técnicas sofisticadas como processamento de linguagem natural (NLP) e aprendizado estatístico.
A Estação de Validação UiPath equipa usuários com capacidade human-in-the-loop para que modelos possam aprender rapidamente e se adaptar a mudanças nos dados. Tecnologia alimentada por inteligência artificial (IA) é tipicamente usada para extração de dados de documentos semi-estruturados e não estruturados. Temos, por exemplo, criado modelos ML para uso em nosso framework de entendimento de documentos para abordar cenários como processamento de recibos e faturas.
Leia mais: Usando IA para Automatizar Processamento de Faturas e Recibos
O desafio de usar técnicas de extração baseadas em modelos é o tempo e expertise que podem levar para criar e implementar modelos ML. Em muitos cenários, porém, técnicas baseadas em modelos são superiores em sua capacidade de aprender e se adaptar a diferentes estruturas e inclusões de documentos.
Adotando extração de dados multi-abordagem
Não há bala de prata para atender a todas as necessidades de processamento de documentos. Ambas as abordagens baseadas em regras e baseadas em modelos para extração de dados são ferramentas potentes, mas limitadas em suas habilidades de processar otimamente a gama de documentos que as empresas gerenciam.
Alguns documentos estruturados podem precisar de muito mais do que apenas metodologias baseadas em regras, pois alguns dados não podem ser extraídos com a ajuda de regras ou templates. Da mesma forma, métodos exclusivamente baseados em modelos não funcionam para todos os documentos não estruturados e semi-estruturados.
Queremos que usuários possam combinar facilmente diferentes abordagens para extrair informação de um único documento. Por isso, projetamos nosso framework de entendimento de documentos para dar a você o poder de superar limitações impostas por qualquer abordagem individual. Recomendamos fortemente usar extração de dados multi-abordagem quando você está lidando com documentos complexos e deseja atingir os mais altos níveis de precisão durante o processo de extração de dados.
Extração de dados multi-abordagem rápida e precisa
Usando nosso framework flexível, você pode misturar e combinar abordagens de processamento de documentos simplesmente colocando múltiplas técnicas de extração de dados diretamente em seu fluxo de trabalho no UiPath Studio.
Você pode facilmente configurar extratores para processamento de dados, definir ordem de preferência para execução de extração e definir um valor como limite para certos resultados de extrator serem aceitos como válidos. Dessa forma, nem estrutura de documento variável nem regras complicadas para extração de dados representarão mais um desafio. Ao mesmo tempo, dentro de automação ponta a ponta, você obtém processamento de documentos mais rápido e muito mais preciso com a mais recente tecnologia de IA.
Interessado?
Ter capacidades eficientes e precisas de extração e processamento de documentos é crucial. Através de nossa ênfase em extração de dados multi-abordagem, queremos tornar o processamento e análise de documentos o mais fácil possível para clientes UiPath.
Atualmente, capacidades estendidas de Document Understanding e funcionalidades estão disponíveis como Software-as-a-Service (SaaS) em versão beta para usuários envolvidos em pilotos anteriores. Você pode esperar que esses recursos e outras ferramentas avançadas de Document Understanding estejam disponíveis em breve. Enquanto isso, encorajamos você a se inscrever para o teste empresarial UiPath para obter acesso à solução UiPath Document Understanding.
Sistema de controle de automação
- Exército dos EUA Avança em Manutenção Baseada em Condição com Sensores Inovadores e Análise Preditiva
- Design Higiênico para Indústrias de Alimentos & Processamento: Da Limpeza à Economia de Custos
- Como IIoT e Análise de Dados Transformam EHS: Aumentando Segurança, Eficiência e Economia
- Como Dados de Sensores e Operacionais Impulsionam a Rentabilidade de um Grande Fabricante de Caminhões
- Edge AI: Por Que o Processamento Está a Migrar para a Camada do Dispositivo
- Fog Computing Explicado: Transformando o Fluxo de Dados IoT e Reduzindo Carga na Nuvem
- Revolucionando a Gestão de Frotas: Integração de IA e IoT para Operações Mais Inteligentes
- ABB revela automação em nuvem de ponta para data centers
- Ambarella, Lumentum e ON Semiconductor Revelam Soluções de Sensoriamento 3D com IA para Dispositivos AIoT de Próxima Geração
- IoT Industrial e Análise Preditiva: Acelerando a Eficiência na Manufatura