



Projetando Perceptron Flexível em Python: Arquitetura, Bias e Ativação
Construindo Perceptron para Classificação: Arquitetura, Bias e Ativação
Bem-vindo à série de redes neurais do All About Circuits. Nossos posts anteriores cobriram fundamentos teóricos de redes neurais:
- Como Realizar Classificação Usando Rede Neural: O Que é o Perceptron?
- Como Usar Exemplo Simples de Perceptron para Classificar Dados
- Como Treinar um Perceptron Básico
- Entendendo Treinamento Simples de Rede Neural
- Introdução à Teoria de Treinamento para Redes Neurais
- Entendendo Taxa de Aprendizado em Redes Neurais
- Machine Learning Avançado com Perceptron Multicamada
- Função de Ativação Sigmoid: Ativação em Perceptrons Multicamadas
- Como Treinar um Perceptron Multicamada
- Entendendo Fórmulas de Treinamento e Backpropagation para Perceptrons Multicamadas
- Arquitetura de Rede Neural para Implementação Python
- Como Criar um Perceptron Multicamada em Python
- Processamento de Sinais Usando Redes Neurais: Validação no Design de Redes Neurais
- Datasets de Treinamento para Redes Neurais: Como Treinar e Validar uma Rede Neural Python
Agora estamos prontos para traduzir esta teoria em sistema de classificação Perceptron funcional. A seção a seguir descreve a arquitetura que implementaremos em Python, com escolhas de design claras que tornam o código portável para outras linguagens como C.
Arquitetura da Rede Neural Python
O diagrama abaixo ilustra a estrutura da rede que codificaremos:
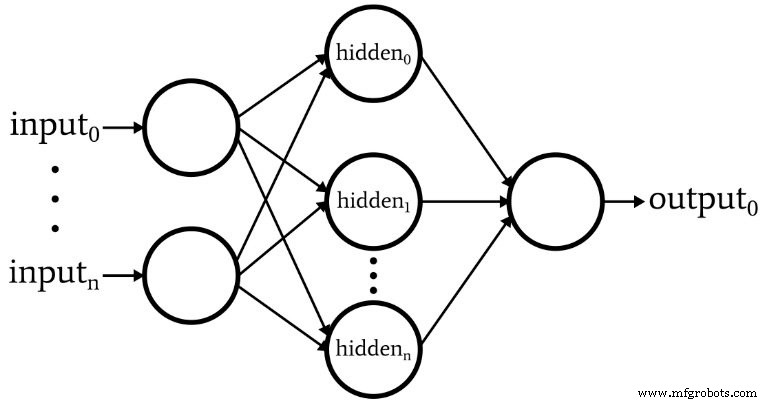
- Nós de entrada variáveis — Essencial para corresponder dimensionalidade de dados do mundo real.
- Única camada oculta — Uma única camada oculta é suficiente para muitas tarefas de classificação, simplificando implementação.
- Nós ocultos variáveis — Contagem ótima é encontrada empiricamente; discutiremos heurísticas em post futuro.
- Nós de saída fixos (1) — Simplifica programa inicial; versões futuras podem suportar saídas multi-classe.
- Função de ativação — Camadas oculta e de saída usam sigmoid logístico: f(x)=1/(1+e^{-x}).
O Que é Nó de Bias? (Bias Aumenta Flexibilidade do Perceptron)
Nós de bias — ou simplesmente biases — são constantes adicionadas à soma ponderada de um nó antes da ativação. Tipicamente definidos como 1 e podem ser colocados na camada de entrada ou oculta.
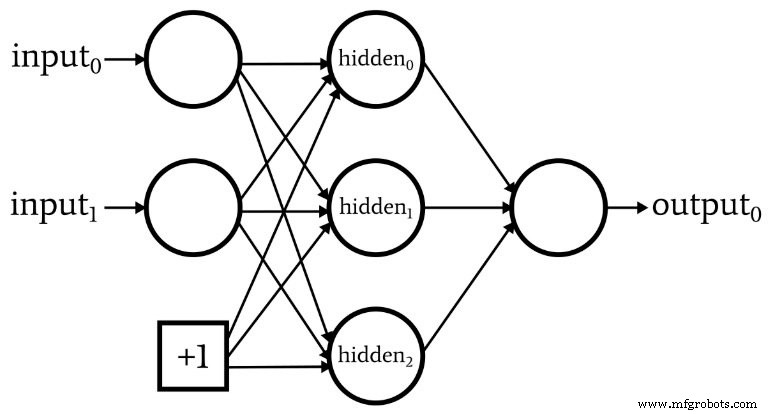
Pesos de bias são atualizados como qualquer outro peso durante backpropagation. Incluir nós de bias permite que a rede desloque sua fronteira de decisão, melhorando desempenho em dados não-linearmente separáveis.
Na Parte 10 desta série, descrevemos pré-ativação como produto escalar: S_preA = w · x = Σ(w_i x_i). Adicionando bias b modifica isto para:
S_preA = (w · x) + b = Σ(w_i x_i) + b
O bias efetivamente age como intercepto y na equação linear y = mx + b, deslocando a curva de ativação horizontalmente.
Pesos, Bias e Ativação
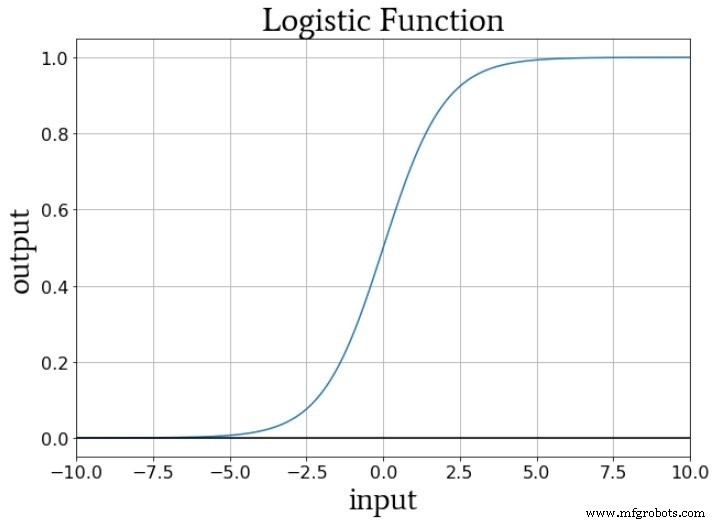
Durante treino, pesos escalam a inclinação da entrada, enquanto bias a desloca verticalmente. Com sigmoid logístico f_A(x) = 1/(1+e^{-x}), a transição de 0 a 1 é centrada em x = 0. Ajustando o bias move esta transição esquerda ou direita, e a magnitude do peso controla a inclinação da transição.
Conclusão
Descrevemos as escolhas arquiteturais centrais para nosso Perceptron e explicamos o papel de nós de bias. No próximo artigo, mergulharemos no código Python que dá vida a este design.
Robô industrial
- 5 Métricas de Rede Essenciais para Otimizar Desempenho na Nuvem
- Arquitetura de Rede AWS Cloud: Guia Prático
- Dominando Loops For em Python: Sintaxe, Exemplos e Padrões Avançados
- Arquitetura NB-IoT Desmistificada: Guia Prático para Engenheiros IoT
- Encontrando Alternativa Confiável ao Z‑Wave: Redes Mesh e Estrela em 2,4 GHz
- CEVA Revela NeuPro-S: Processador IA Next-Gen para Inferência Deep Neural Network na Edge
- Infraestrutura de Rede: A Pedra Angular do Sucesso de Veículos Autônomos
- Programação de Rede em Python: Sockets e Protocolos Avançados
- 5 Estratégias Essenciais de Segurança de Rede para Pequenas Empresas
- Por Que o 5G é Essencial para Liberar Todo o Potencial da IoT