



Treinando Perceptron Básico com Python: Guia Passo a Passo
Treinando Perceptron Básico com Python
Este guia o conduz através de uma implementação Python totalmente comentada que aprende automaticamente pesos para um perceptron de camada única. O código está pronto para copiar-colar, executar e adaptar aos seus próprios dados.
Explore a Série Perceptron do AAC
Para contexto mais profundo ou para pular para tópicos avançados, confira o resto de nossos artigos:
- Como Realizar Classificação Usando Rede Neural: O Que é o Perceptron?
- Como Usar Exemplo Simples de Perceptron para Classificar Dados
- Como Treinar um Perceptron Básico
- Entendendo Treinamento Simples de Rede Neural
- Introdução à Teoria de Treinamento para Redes Neurais
- Entendendo Taxa de Aprendizado em Redes Neurais
- Machine Learning Avançado com Perceptron Multicamada
- Função de Ativação Sigmoid: Ativação em Perceptrons Multicamadas
- Como Treinar um Perceptron Multicamada
- Entendendo Fórmulas de Treinamento e Backpropagation para Perceptrons Multicamadas
- Arquitetura de Rede Neural para Implementação Python
- Como Criar um Perceptron Multicamada em Python
- Processamento de Sinais Usando Redes Neurais: Validação no Design de Redes Neurais
- Datasets de Treinamento para Redes Neurais: Como Treinar e Validar uma Rede Neural Python
Classificação com Perceptron de Camada Única
Começamos com problema clássico de classificação binária em espaço 3-D. A arquitetura da rede é uma única camada oculta com três nós de entrada e um nó de saída que usa função de ativação unit-step.
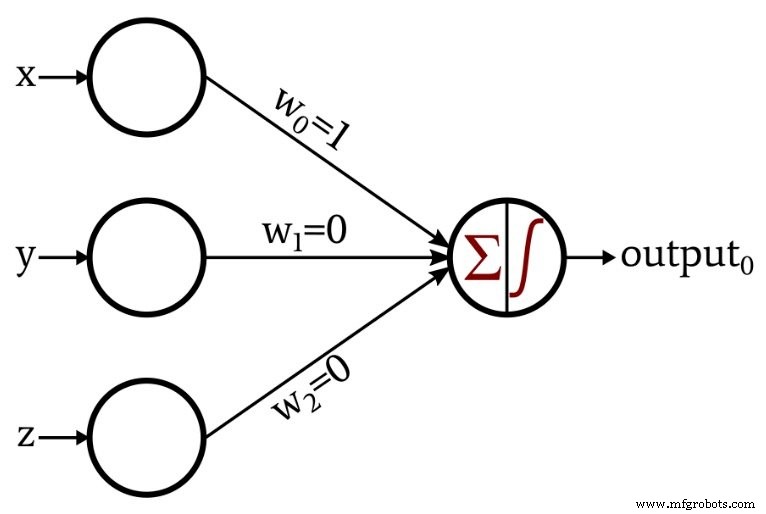
O nó de saída aplica a seguinte função unit-step:
\[f(x)=\begin{cases}0 & x < 0\\1 & x \ge 0\end{cases}\]
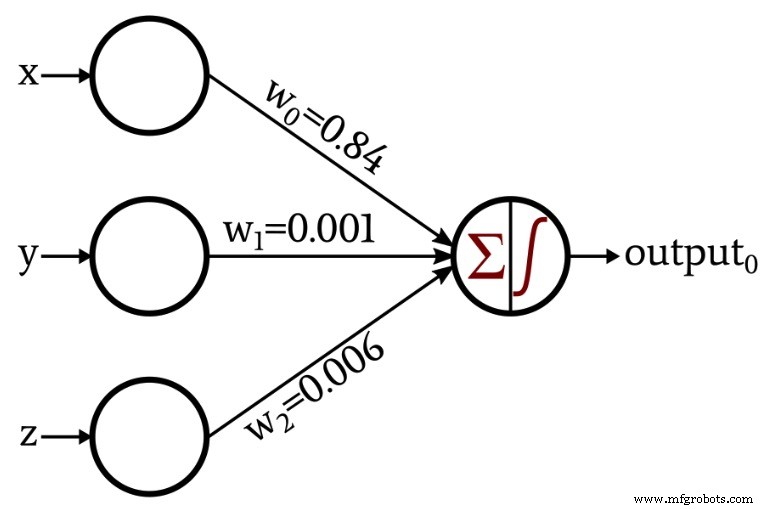
Para ilustrar aprendizado, estendemos a arquitetura para ajustar automaticamente seus pesos via loop de treino simples:
Implementação Python
O script a seguir lê dados de treino de arquivo Excel, inicializa pesos aleatoriamente e os atualiza iterativamente usando a regra de aprendizado do perceptron.
 import pandas
import numpy as np
# Dimensionalidade do espaço de entrada (x, y, z)
input_dim = 3
# Taxa de aprendizado controla magnitude do ajuste de peso
learning_rate = 0.01
# Pesos iniciais aleatórios; pode definir valores fixos para reprodutibilidade
Weights = np.random.rand(input_dim)
# Weights = np.array([0.5, 0.5, 0.5])
# Carregar dataset: planilha com colunas para cada feature e coluna 'output'
Training_Data = pandas.read_excel("3D_data.xlsx")
# Separar outputs esperados da matriz de features
Expected_Output = Training_Data.output
Training_Data = Training_Data.drop(["output"], axis=1)
# Converter para array NumPy para operações vetorizadas
Training_Data = np.asarray(Training_Data)
training_count = len(Training_Data[:, 0])
# Treinar sobre múltiplas épocas
for epoch in range(5):
    for datum in range(training_count):
        # Soma ponderada das entradas
        Output_Sum = np.sum(np.multiply(Training_Data[datum, :], Weights))
        # Aplicar ativação unit-step
        Output_Value = 0 if Output_Sum < 0 else 1
        # Calcular erro entre esperado e real
        error = Expected_Output[datum] - Output_Value
        # Atualizar cada peso segundo regra de aprendizado
        for n in range(input_dim):
            Weights[n] += learning_rate * error * Training_Data[datum, n]
print(f"w_0 = {Weights[0]:.3f}")
print(f"w_1 = {Weights[1]:.3f}")
print(f"w_2 = {Weights[2]:.3f}")
Conceitos-Chave Explicados
Configurando a Rede e Organizando Dados
A rede tem três nós de entrada para corresponder às coordenadas 3-D. Taxa de aprendizado 0.01 é ponto de partida padrão; você pode ajustar após experimentação. Pesos são semeados aleatoriamente para evitar simetria, mas pode defini-los fixos se quiser comportamento determinístico.
Dados de treino são lidos de arquivo Excel, separados em entradas e outputs esperados, e convertidos para array NumPy para computação eficiente.
Calculando Valores de Saída
Cada época itera sobre todas amostras de treino. Para cada amostra, a soma ponderada das entradas é computada. A função unit-step então mapeia esta soma para saída binária: 0 se soma negativa, 1 caso contrário.
Atualizando Pesos
Quando a saída predita difere da esperada, a regra de aprendizado do perceptron ajusta cada peso proporcionalmente ao valor de entrada, erro e taxa de aprendizado:
\[w_{new} = w + (\alpha \times \delta \times input)\]
onde \(\delta = \text{output}_{expected} - \text{output}_{calculated}\) e \(\alpha\) é a taxa de aprendizado.
Conclusão
Você viu agora uma implementação completa e anotada de perceptron de camada única em Python. O código é base sólida para experimentar com diferentes datasets, taxas de aprendizado, ou até estender a rede para múltiplas saídas em projetos futuros.
Integrado
- Sistemas de Detecção de Intrusão: Protegendo sua Rede com Alertas Inteligentes
- Como se Tornar Eletricista Automotivo: Treinamento, Funções e Perspectivas de Carreira
- Endurecendo Dispositivos IoT Industriais para Prevenir Ataques Cibernéticos
- Construa um Modelo de IA Offline que Detecta Estágios de Retinopatia Diabética com Edge Impulse
- CEVA Revela NeuPro-S: Processador IA Next-Gen para Inferência Deep Neural Network na Edge
- Raspberry Pi e HDC2010: Guia Completo de Configuração I2C para Sensor de Temperatura e Umidade
- Descubra Sua Chave de Segurança de Rede: Passos Fáceis para Encontrar e Proteger Seu Wi‑Fi
- 5 Estratégias Essenciais de Segurança de Rede para Pequenas Empresas
- Avaliando a Segurança da Rede do Chão de Fábrica: Você Está Preparado?
- Preparando a Força de Trabalho do Amanhã para a Indústria 4.0: Estratégias de Treinamento para a Fábrica Digital