



Treinando Seu Perceptron Multicamada: Estratégias Comprovadas para Performance Ótima
Podemos melhorar muito o desempenho de um Perceptron adicionando camada de nós ocultos, mas esses nós ocultos também tornam o treino um pouco mais complicado.
Até agora na série AAC sobre redes neurais, você aprendeu sobre classificação de dados usando redes neurais, especialmente da variedade Perceptron.
Acompanhe a série abaixo ou mergulhe nesta nova entrada que explicará os fundamentos da rede neural Perceptron multicamada (MLP).
- Como Realizar Classificação Usando Rede Neural: O Que é o Perceptron?
- Como Usar Exemplo Simples de Perceptron para Classificar Dados
- Como Treinar um Perceptron Básico
- Entendendo Treinamento Simples de Rede Neural
- Introdução à Teoria de Treinamento para Redes Neurais
- Entendendo Taxa de Aprendizado em Redes Neurais
- Machine Learning Avançado com Perceptron Multicamada
- Função de Ativação Sigmoid: Ativação em Perceptrons Multicamadas
- Como Treinar um Perceptron Multicamada
- Entendendo Fórmulas de Treinamento e Backpropagation para Perceptrons Multicamadas
- Arquitetura de Rede Neural para Implementação Python
- Como Criar um Perceptron Multicamada em Python
- Processamento de Sinais Usando Redes Neurais: Validação no Design de Redes Neurais
- Datasets de Treinamento para Redes Neurais: Como Treinar e Validar uma Rede Neural Python
O Que é Rede Neural Perceptron Multicamada?
O artigo anterior demonstrou que um Perceptron de camada única simplesmente não pode produzir o tipo de desempenho que esperamos de uma arquitetura neural network moderna. Um sistema limitado a funções linearmente separáveis não conseguirá aproximar as complexas relações entrada-saída que ocorrem em cenários reais de processamento de sinais. A solução é um Perceptron multicamada (MLP), como este:
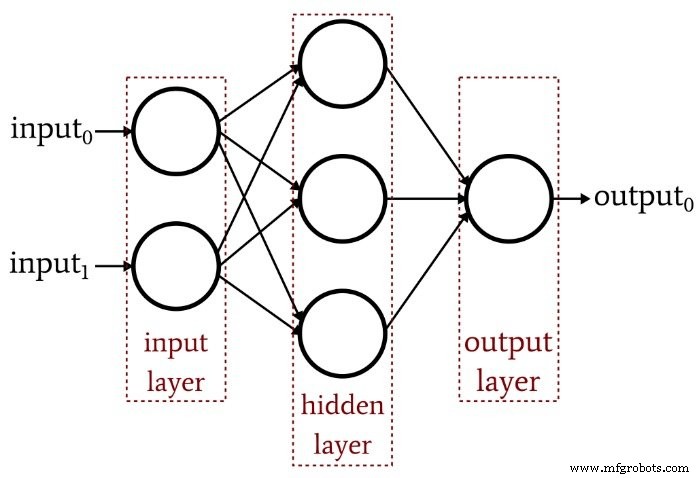
Adicionando essa camada oculta, transformamos a rede em um "aproximador universal" que pode atingir classificação extremamente sofisticada. Mas sempre devemos lembrar que o valor de uma rede neural é completamente dependente da qualidade de seu treino. Sem dados de treino abundantes, diversos e procedimento de treino eficaz, a rede nunca "aprenderá" como classificar amostras de entrada.
Por Que a Camada Oculta Complica o Treino?
Vamos olhar a regra de aprendizado que usamos para treinar um Perceptron de camada única em artigo anterior:
\[w_{new} = w+(\alpha\times(output_{expected}-output_{calculated})\times input)\]
Observe a suposição implícita nesta equação: Atualizamos pesos baseados na saída observada, então para isso funcionar, os pesos no Perceptron de camada única devem influenciar diretamente o valor de saída. É como escolher temperatura da água da torneira girando dois botões para quente e frio. A relação entre temperatura geral e ação do botão é direta, e até quem não gosta de matemática encontra temperatura desejada mexendo nos botões por um tempo.
Mas agora imagine que o fluxo de água pelos canos quente e frio está relacionado à posição do botão de forma complexa e altamente não-linear. Você gira lenta e firmemente o botão de água quente, mas a vazão resultante varia erraticamente. Tenta o botão de água fria e faz a mesma coisa. Ajustar a temperatura ideal sob estas condições — especialmente já que a "saída" deve ser alcançada através de combinação de duas relações de controle confusas — seria muito mais difícil.
É assim que entendo o dilema da camada oculta. Pesos que conectam nós de entrada aos nós ocultos são conceitualmente análogos a aqueles botões mecanicamente erráticos — porque pesos entrada-para-oculta não têm caminho direto para camada de saída, a relação entre esses pesos e a saída da rede é tão complexa que a regra de aprendizado simples mostrada acima não será eficaz.
Novo Paradigma de Treino
Como a regra de aprendizado original do Perceptron não pode ser aplicada a redes multicamadas, precisamos repensar nossa estratégia de treino. O que faremos é incorporar gradiente descendente e minimização de função de erro.
Uma coisa a ter em mente é que este procedimento de treino não é específico a redes neurais multicamadas. Gradiente descendente vem de teoria de otimização geral, e o procedimento de treino que empregamos para MLPs também é aplicável a redes de camada única. No entanto, como entendo, gradiente descendente estilo MLP é (pelo menos teoricamente) desnecessário para Perceptron de camada única, porque a regra mais simples mostrada acima eventualmente fará o trabalho.
Derivar as equações reais de atualização de peso para MLP envolve matemática intimidante que não tentarei explicar inteligentemente neste momento. Meu objetivo para o resto deste artigo é fornecer introdução conceitual a dois aspectos-chave do treino MLP — gradiente descendente e função de erro — e continuaremos esta discussão no próximo artigo incorporando nova função de ativação.
Gradiente Descendente
Como o nome implica, gradiente descendente é meio de descer em direção ao mínimo de uma função de erro baseada na inclinação. O diagrama abaixo transmite como um gradiente nos dá informação sobre como modificar pesos — a inclinação de um ponto na função de erro nos diz qual direção ir e quão longe estamos do mínimo.
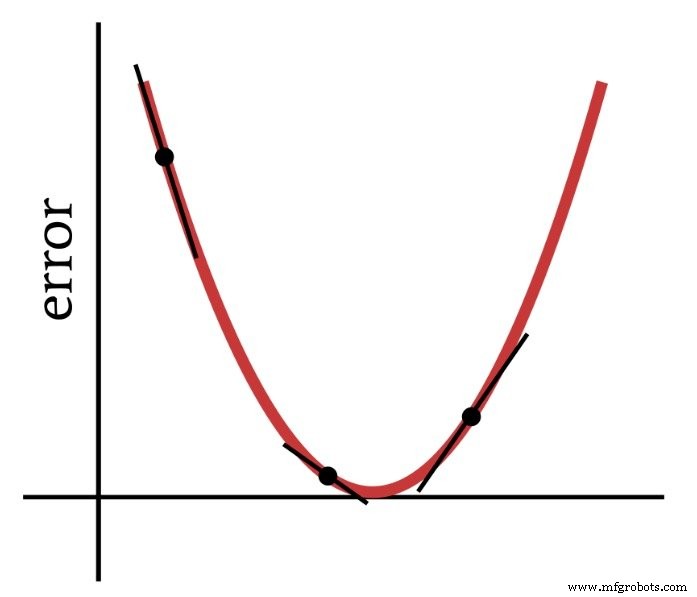
Assim, a derivada da função de erro é elemento importante dos computos que usamos para treinar Perceptron multicamada. Na verdade, precisaremos de derivadas parciais aqui. Quando implementamos gradiente descendente, fazemos cada modificação de peso proporcional à inclinação da função de erro em relação ao peso sendo modificado.
Função de Erro (AKA Função de Perda)
Método comum de quantificar erro de rede neural é elevar ao quadrado a diferença entre valor esperado (ou "alvo") e valor calculado para cada nó de saída, e então somar todas estas diferenças quadradas. Você pode chamar isso de "soma de diferenças quadradas" ou "erro quadrático somado" ou várias outras coisas, e também verá abreviação LMS, que significa least-mean-square, porque o objetivo do treino é minimizar o erro quadrático médio. Esta função de erro (denotada por E) pode ser expressa matematicamente assim:
\[E=\frac{1}{2}\sum_k(t_k-o_k)^2\]
onde k indica a faixa de nós de saída, t é valor de saída alvo, e o é valor de saída calculado.
Conclusão
Estabelecemos base para treinar com sucesso Perceptron multicamada, e continuaremos explorando este tópico interessante no próximo artigo.
Robô industrial
- Entendendo Topologias de Rede: De Ponto-a-Ponto a Anel e Estrela
- Como se Tornar Eletricista Automotivo: Treinamento, Funções e Perspectivas de Carreira
- Endurecendo Dispositivos IoT Industriais para Prevenir Ataques Cibernéticos
- CEVA Revela NeuPro-S: Processador IA Next-Gen para Inferência Deep Neural Network na Edge
- Como Redes Conectadas Estão Revolucionando a Agricultura Moderna
- Como Redes Inteligentes Impulsionam Eficiência e Crescimento Empresarial
- Descubra Sua Chave de Segurança de Rede: Passos Fáceis para Encontrar e Proteger Seu Wi‑Fi
- Redes Neurais Artificiais Impulsionam Desempenho de Comunicações Sem Fio
- Avaliando a Segurança da Rede do Chão de Fábrica: Você Está Preparado?
- Preparando a Força de Trabalho do Amanhã para a Indústria 4.0: Estratégias de Treinamento para a Fábrica Digital