



Acelerando Co-Design CPU-FPGA: Fluxo Prático para Desenvolvedores de Software
Recentemente, Brian Bailey convocou uma mesa-redonda que culminou no artigo em duas partes Supporting CPUs + FPGAs. Especialistas debateram a realidade emergente de sistemas que fundem FPGAs com CPUs, destacando como novos fluxos de design capacitam desenvolvedores de software a levar plataformas CPU+FPGA ao mercado mais rápido.
Introdução
A ascensão da inteligência artificial, a explosão de dispositivos conectados e a aceleração de cargas de trabalho em data centers apontam para um motor comum: desenvolvedores de software buscando velocidade. Links de baixa latência entre FPGAs e CPUs, aliados aos modestos envelopes de potência de FPGAs modernos, tornam sistemas híbridos CPU-FPGA uma escolha natural para desempenho exigente. No entanto, a complexidade subjacente da tecnologia FPGA frequentemente trava desenvolvedores.
Ferramentas de Síntese de Alto Nível (HLS) avançaram significativamente, facilitando o mapeamento de C/C++ para hardware. Ainda assim, elas são principalmente centradas em IP e falham em decisões de nível de sistema — balancear tarefas software vs hardware, escolher entre execução pipeline ou paralela, ajustar granularidade de dados ou selecionar mecanismos ótimos de comunicação.
O que engenheiros de software precisam é um fluxo de design unificado que pareça uma IDE de software padrão, mas forneça feedback ciente de hardware. Soluções comerciais recentes começaram a fechar essa lacuna abstraindo detalhes de baixo nível enquanto retêm o controle que desenvolvedores demandam. Essas ferramentas baseiam-se na filosofia de Design de Nível de Sistema descrita em ESL Models and Their Application.
Entendendo o Fluxo de Design de Nível de Sistema
Design de Nível de Sistema opera em abstração mais alta, validando, refinando e integrando componentes do sistema antes da implementação. A maioria dos designers começa no nível algorítmico, escrevendo modelos em C/C++/SystemC, MATLAB, Simulink ou LabVIEW que capturam o comportamento completo do sistema.
Focamos em um fluxo centrado em C/C++ (ver Figura 1). A primeira etapa — profiling da aplicação — identifica quais funções ou loops poderiam se beneficiar de aceleração em hardware. Em seguida, a plataforma CPU/FPGA alvo é especificada (ex.: ARM Cortex-A53 + FPGA) e seus parâmetros (clock, cache, interconexões) são configurados. Por fim, as tarefas perfiladas são mapeadas entre software e hardware, culminando em uma arquitetura executável.
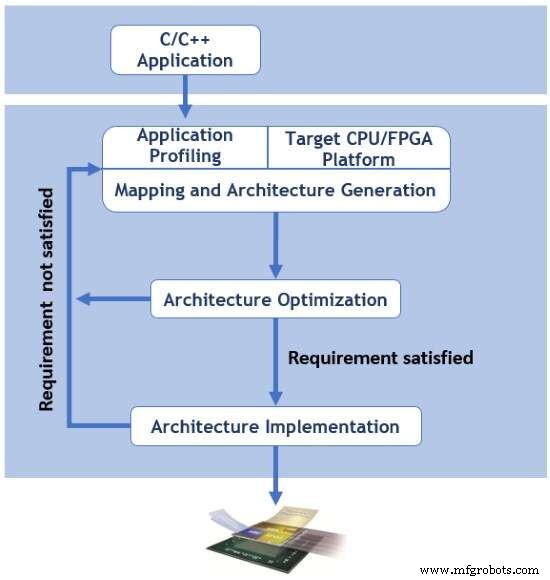
Figura 1. Fluxo típico de design de nível de sistema para CPU/FPGA (Fonte: Space Codesign Systems, Inc.)
O segundo bloco da Figura 1 cobre otimização de arquitetura — às vezes chamada exploração arquitetural ou verificação de desempenho — mostrada em mais detalhe na Figura 2.
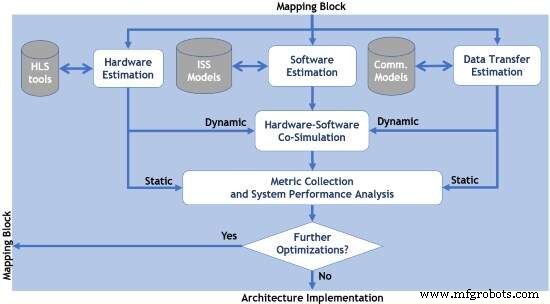
Figura 2. Processo de otimização de arquitetura (Fonte: Space Codesign Systems, Inc.)
Três estimadores-chave alimentam este estágio:
- Estimativa de hardware avalia o impacto de mover código C/C++ para o FPGA, detalhando uso de recursos, latência de loop e potência. Baseia-se em saídas de HLS.
- Estimativa de software mede métricas do lado CPU — carga do processador, troca de tarefas, misses de cache — complementando a visão de hardware.
- Estimativa de transferência de dados modela interfaces (mapeadas em memória ou streaming), capturando latência de barramento, throughput, profundidade de fila e pegada de memória.
Resultados agregados populam um banco de dados, permitindo que desenvolvedores verifiquem se metas de nível de sistema são atingidas. Arquiteturas que satisfazem os critérios avançam; caso contrário, iterações de otimização adicionais são disparadas.
O bloco final da Figura 1 concerne implementação da arquitetura: designs de alto nível são traduzidos em bitstreams FPGA usando ferramentas de fornecedores como Xilinx Vivado ou Intel Quartus Prime, produzindo um sistema totalmente sintetizado e testável pronto para implantação.
Otimização de Nível de Sistema
A ausência de ferramentas de otimização automatizadas de ponta a ponta tem sido um gargalo em computação baseada em FPGA. A complexidade de balancear múltiplas dimensões de design torna exploração manual tediosa, mesmo para designers experientes.
A Figura 3 ilustra um fluxo típico de otimização para uma aplicação de processamento de imagem compreendendo seis funções C/C++ implantadas em plataforma Zynq-7000. Oito arquiteturas candidatas são consideradas, mas restrições de time-to-market exigem seleção rápida do melhor compromisso entre desempenho, área e potência.
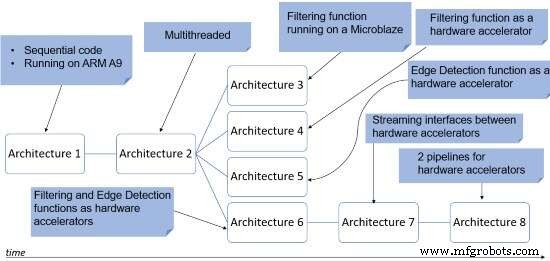
Figura 3. Exploração de arquitetura com decisões de nível de sistema destacadas (Fonte: Space Codesign Systems, Inc.)
Soluções comerciais como Xilinx SDSoC/SDAccel, Merlin Compiler da Falcon Computing e SpaceStudio da Space Codesign agora fornecem suporte de ponta a ponta. Elas espelham o fluxo das Figuras 1 e 2 enquanto injetam lógica de decisão automatizada:
- SDSoC estima latências para kernels de hardware e caracteriza transferência de dados na plataforma alvo, então faz benchmark contra execução puramente em software.
- Merlin Compiler aplica transformações source-to-source dirigidas por quatro pragmas, além de passes implícitos do compilador que aumentam pipeline e paralelismo.
- SpaceStudio constrói uma plataforma virtual (VP) que simula o sistema inteiro, integrando latências geradas por hardware e oferecendo profiling não intrusivo de tarefas software e hardware.
Visão do Ecossistema Comercial
A Figura 4 apresenta uma visão em camadas do ecossistema em torno do design de plataformas CPU/FPGA. A camada superior mostra pontos de entrada algorítmicos; a camada intermédia hospeda ferramentas que suportam otimizações de nível de sistema a partir de C/C++; a camada inferior contém ferramentas de síntese de fornecedores que produzem bitstreams. Plataformas CPU/FPGA representativas são ilustradas na base.
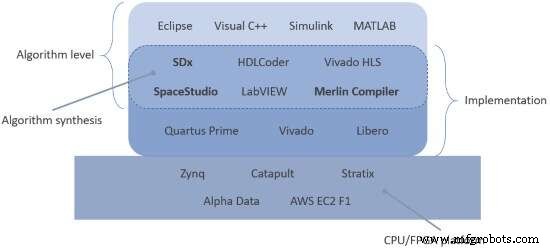
Figura 4. Ecossistema comercial para plataformas CPU/FPGA (Fonte: Space Codesign Systems, Inc.)
A Tabela 1 lista principais ferramentas de automação comercial empregadas em design de plataformas CPU/FPGA.
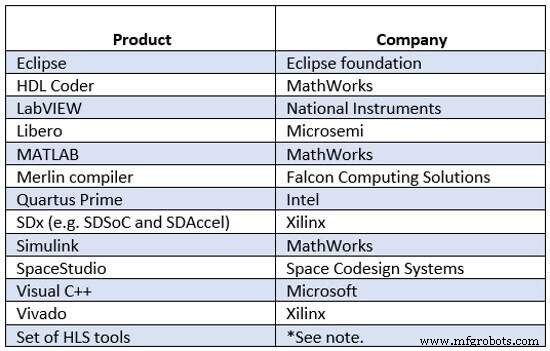
Tabela 1. Ferramentas de automação comercial (*Nota: uma lista é proposta nesta revisão)
Conclusão
Democratizar o desenvolvimento CPU+FPGA é o objetivo final, permitindo que um espectro mais amplo de desenvolvedores de software aproveite aceleração de hardware. Assim como a indústria de software evoluiu de assembly para Python e Swift ao longo de cinco décadas, a programação FPGA passa por maturação similar. O surgimento de ferramentas de nível de sistema como SpaceStudio, SDSoC e Merlin Compiler sinaliza uma mudança crucial — ainda que automação total e otimização contínua entre compiladores permaneçam marcos futuros.
Guy Bois, Ing., PhD é Fundador da Space Codesign Systems e Professor no Departamento de Engenharia de Software e Computação da Polytechnique Montréal. Com extensa experiência em P&D junto a líderes da indústria — STMicroelectronics, Grass Valley, PMC Sierra, Design Workshops Technologies e Cadabra Systems — a expertise de Guy em co-design hardware/software levou à comercialização do SpaceStudio e fundação da Space Codesign Systems Inc.
Integrado
- CEO da AMendate, Thomas Reiher, sobre Revolucionar Impressão 3D com Otimização Topológica Automatizada
- Ravi Kunju da Altair Discute Design Orientado por Simulação e Novo Inspire Print3D para Impressão 3D
- 5 Perguntas Reveladoras com Stefan Ferber, CEO da Bosch.IO
- Iniciativa VE-VIDES Revela Framework Confiável de Design & Verificação para Segurança IoT
- Cadence Lança Ferramenta Cerebrus ML-Driven para Aumentar Produtividade de Design de Chip 10x e PPA 20%
- Cadence e UMC Certificam Fluxo AMS 28HPC+ para Desenvolvimento Acelerado de Chips Automotivos, IoT e IA
- Aprimore Suas Plataformas de Robôs de Baixo Custo com Novo Hardware de 7º Eixo e Software Gratuito de Programação Digital Twin
- Infineon & Elektrobit Entregam Segurança de Próxima Geração para Carros Conectados
- Omron lança Flow Core: software avançado que melhora confiabilidade e flexibilidade de robôs móveis
- Navegando no Novo Cenário de Manufatura: Estratégias para o Sucesso