



Data Lake vs. Big Data: Escolhendo a Abordagem Certa para Aplicações Industriais
Data lake e big data são dois termos modernos frequentemente mal compreendidos e usados incorretamente. Devido aos grandes volumes de dados implícitos, esses termos às vezes são usados indistintamente. No entanto, data lake e big data são diferentes, mesmo que suas definições atuais ainda não estejam totalmente estabelecidas.
Figura 1. Dados modernos podem vir de muitas fontes e ser de diferentes tipos. Imagem usada com cortesia da Analytics Vidhya
Vamos primeiro olhar para um breve contexto histórico. No final dos anos 2000, com o crescimento explosivo de plataformas de mídia social, como Facebook e Twitter, muitos cientistas de dados começaram a perceber o potencial de tais plataformas para gerar grandes quantidades de dados pessoais valiosos. Consequentemente, novos aplicativos de software foram desenvolvidos para facilitar o processamento e análise de dados. Um exemplo proeminente é o Apache Hadoop, essencialmente um kit de ferramentas de aplicativos de código aberto que pode processar informações em nível de big data.
Na próxima década, a Internet das Coisas (IoT) entrou em cena. Isso abriu as portas para milhões de fontes de dados que poderiam fornecer insights sobre preferências e padrões de uma pessoa, enquanto também enviavam informações sobre o próprio produto.
Simultaneamente, o aprendizado de máquina estava fazendo avanços importantes e encontrando mais aplicações práticas no cenário industrial. Isso resultou em uma necessidade crescente de lidar com grandes volumes de dados nas indústrias, particularmente em processos automatizados.
Todas as projeções indicam que a quantidade total de dados disponíveis no mundo continuará a se expandir em taxas aceleradas nos próximos anos. Para referência, em 2016, o mundo passou a marca de 1 Zettabyte de tráfego de internet anual gerado. Um Zettabyte equivale a 1 trilhão de Gigabytes.
O tráfego de internet anual deve ultrapassar 3 Zettabytes em 2021. Essas projeções, junto com as capacidades expandidas da computação em nuvem, indicam que o valor e os usos de big data (e data lakes) talvez estejam apenas começando.
O Que é Big Data?
Olhando simplesmente pela perspectiva de volume, a definição de big data é um alvo móvel. À medida que a quantidade de dados e espaço de armazenamento disponível continua a crescer, o benchmark do que é considerado grandes quantidades de informação também cresce.
Hoje, um repositório de dados de 100 Terabytes ou mais é geralmente considerado na faixa de big data. Grandes repositórios de dados, como os de plataformas de mídia social, podem estar na faixa de vários Petabytes.
Outra referência usada para definir big data é quando a quantidade de informação não pode ser manejada por ferramentas de computador tradicionais, como SQL. Por exemplo, hoje não é incomum que bancos de dados atinjam 1 Terabyte de tamanho anualmente. Mas, com aplicações SQL se tornando mais poderosas, essa magnitude de banco de dados ainda pode ser gerenciada; portanto, não são tipicamente considerados big data.
Modelo 4V do Big Data
Até agora, olhamos para a definição de big data pela perspectiva de volume. Existem três outros fatores importantes a considerar: velocidade, variedade e veracidade. Juntos com o volume, formam o modelo 4V.
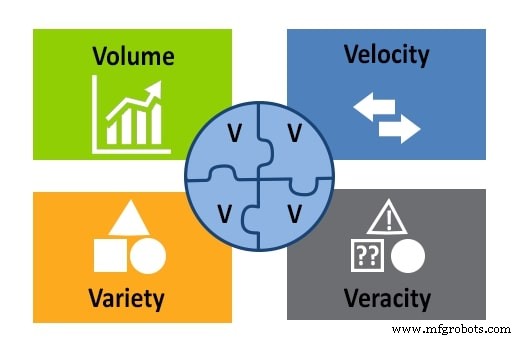
Figura 2. O modelo 4V do big data: Volume, velocidade, variedade e veracidade. Imagem usada com cortesia da APSense
Variedade refere-se a todos os diferentes tipos de dados armazenados em um repositório de big data: texto, imagens, som, vídeo, etc. Também se refere ao fato de que os dados podem vir de múltiplas fontes.
Velocidade é uma consideração importante no big data porque a informação está constantemente fluindo. Velocidade preocupa-se com a velocidade na qual os dados são coletados, gerados e distribuídos.
Veracidade mede a precisão e qualidade dos dados para avaliar se um cientista de dados pode usá-los para análise e para tirar conclusões a partir deles.
Agora que entendemos big data, vamos revisar data lakes antes de mergulhar em como usar esses em um sistema de controle.
O Que é um Data Lake?
Data lakes são repositórios centralizados de grandes quantidades de dados brutos, que são informações que podem ou não ser valiosas no futuro e cujo propósito não é 100% conhecido ainda. Data lakes podem armazenar bancos de dados relacionais e não relacionais, junto com outros tipos de arquivos e entidades.
Embora a informação em um data lake não seja processada ou organizada, ela é estruturada de forma que todas as entradas e saídas sejam consideradas para criar uma boa arquitetura.
Data Lake vs. Big Data
Um data lake é uma instância de uma aplicação de big data. Eles seguem os critérios descritos no modelo 4V, com algumas particularidades adicionais. Em termos de volume, data lakes estão, em média, na extremidade inferior do que é considerado big data.
Informações em data lakes têm variedade, mas a condição é que sejam apenas dados brutos não processados. Velocidades de entrada e saída são tão relevantes quanto em qualquer sistema moderno e avaliações de qualidade de dados são realizadas em um data lake bem projetado.
Aplicações Industriais para Dados
A automação avançada está impulsionando um rápido aumento na quantidade de informação manejada no chão de fábrica. Graças a isso, processos de manufatura e outros industriais estão agora entrando no reino do big data, com várias atividades de negócios agora empregando ferramentas como data lakes.
Um exemplo proeminente é manutenção preditiva. A capacidade de prever uma falha mecânica ou elétrica é muito valiosa e pode proporcionar economia substancial em custos de reparo. Data lakes são ferramentas úteis que podem compilar informações vindas de arquivos de log, múltiplos sensores e dispositivos de entrada, que podem ser usados para entender tendências e prever problemas.
Aprendizado de máquina é um conceito no qual robôs são fornecidos com informações que podem ajudá-los a se adaptar a condições externas cambiantes. Capturar informação é semelhante à manutenção preditiva, com a etapa adicional de que avaliações e mudanças no processo são automaticamente alimentadas ao controlador do sistema. Dados de aprendizado de máquina podem ser armazenados em um data lake estruturado.
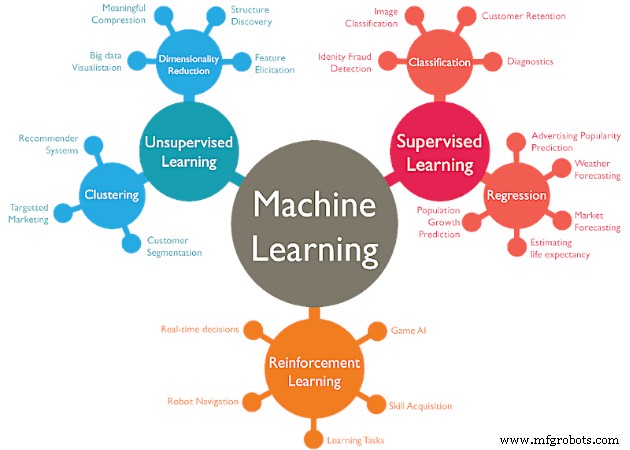
Figura 3. Aprendizado de máquina tem várias estratégias que cada uma requer grandes quantidades de dados. Imagem usada com cortesia da WordStream
Para concluir, um data lake é uma instância de uma aplicação de big data. Estas duas formas de visualizar dados podem trabalhar juntas. Ao utilizar tanto big data quanto data lake, um engenheiro de controle pode prever falhas, criar rotinas de manutenção, expandir a transformação digital da instalação e muito mais.
Para que você usa big data e data lakes no seu trabalho?
Tecnologia da Internet das Coisas
- Como Sensores Conectados e Processadores Inteligentes Impulsionam a Indústria 4.0
- Cervoz Guide: Selecionar Flash Storage Fiável para Aplicações Industriais
- GE lança Predix Cloud: Plataforma dedicada para dados e análises industriais
- Perspectiva Futura: Avançando Industrial IoT para Excelência em Produção
- Top 4 Desafios Enfrentados pela Internet Industrial das Coisas (IIoT)
- Seis Princípios-Chave para Construir Aplicações IoT de Alto Impacto Orientadas a Sensores
- Aproveitando RTUs para Insights de Big Data em Operações Industriais
- Construindo Fundações para Sucesso em Data Science Industrial
- IoT Industrial: Da Captura de Dados à Tomada de Decisão em Tempo Real
- Big Data Pode Revolucionar Orçamentos de Saúde? Insights da Lux Research