



Computação Analógica In-Memory: Inferência de IA na Edge Eficiente em Potência
Machine learning e deep learning estão agora tecidos na tecnologia cotidiana. De assistentes de linguagem natural a detecção de objetos em tempo real, IA impulsiona um número crescente de dispositivos de consumo e industriais. Ainda, a maioria destas aplicações depende de motores de inferência baseados em nuvem — uma arquitetura que levanta preocupações sobre privacidade, consumo de energia, latência e custo.
Implantar IA localmente na edge pode eliminar esses problemas. O principal obstáculo é o dreno de potência movido a memória de aceleradores digitais de rede neural convencionais. Quando pesos e ativações são buscados de DRAM ou SRAM, o movimento de dados sozinho consome duas a três ordens de magnitude mais energia que a aritmética em si. Computação analógica in-memory aborda este gargalo realizando operações multiply-accumulate (MAC) diretamente dentro de um array de memória não-volátil.
IA Baseada em Nuvem: Os Pontos Dolorosos
Quando um dispositivo edge encaminha dados brutos para um servidor remoto, várias questões surgem:
- Privacidade e segurança — Informação pessoal ou confidencial é transmitida e armazenada em data centers.
- Uso de potência desnecessário — Cada bit enviado pelo rádio, armazenado na nuvem e re-recuperado queima energia.
- Latência para inferência small-batch — Respostas podem levar mais de 100ms, o que é perceptível para usuários.
- Ineficiência de economia de dados — Sensores geram streams massivos; fazer upload de tudo não é nem econômico nem sustentável.
Para superar estes desafios, um modelo treinado é primeiro construído em plataforma de alto desempenho (nuvem, GPU farm, etc.). Os pesos resultantes são então mapeados para um motor de inferência leve que executa a computação localmente.
A Natureza MAC-Pesada de Redes Neurais
Mesmo modelos leves são dominados por MACs. Por exemplo, MobileNet-v1 com input 224×224 contém 4.2 milhões de parâmetros e requer 569 milhões de MACs por inferência. A multiplicação e acumulação são realizadas em produto denso matriz-vetor.
Por Que Computação Digital Luta
Em um acelerador convencional, pesos e ativações são armazenados em DRAM/SRAM e devem ser buscados para uma arithmetic logic unit (ALU). A Figura 3 ilustra o gargalo de memória: a energia gasta movendo dados (50-100 pJ por transferência) supera em muito os 250 fJ por operação MAC. Mesmo com técnicas agressivas de data-reuse, a arquitetura Von Neumann impõe um limite duro em eficiência de potência.
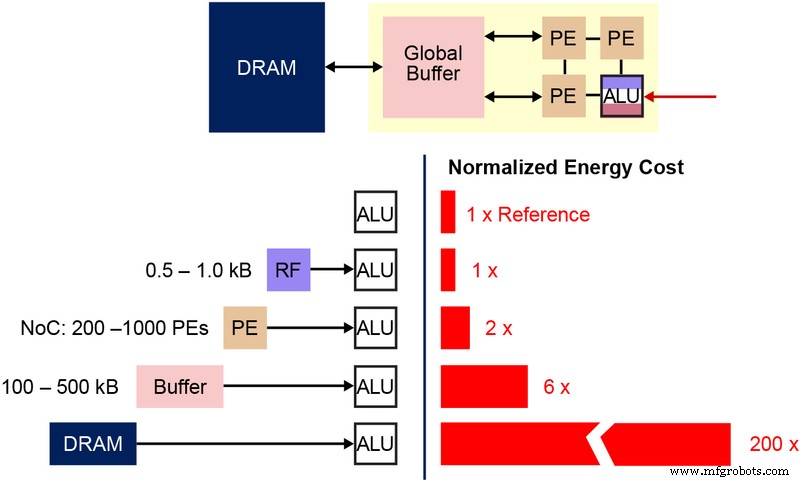 Figura 3: Gargalo de Memória em Computação de Machine Learning. (Fonte: Y.-H. Chen, J. Emer, e V. Sze, "Eyeriss: A Spatial Architecture for Energy-Efficient Dataflow for Convolutional Neural Networks," ISCA, 2016.)
Computação Analógica In-Memory ao Resgate
Ao embutir computação no próprio array de memória, a necessidade de shuttle de pesos desaparece. A transferência de dados restante é limitada ao sinal de entrada, que tipicamente é uma saída de sensor. Células flash operando no regime sub-threshold consomem correntes sub-nanoamp, tornando potência ativa negligenciável. Em standby, células não-voláteis retêm dados sem qualquer consumo de potência.
A plataforma memBrain™ da Silicon Storage Technology (uma empresa Microchip) exemplifica esta abordagem. Construída na tecnologia de memória SuperFlash® (ESF3), cada bitcell pode ser programada para uma tensão de threshold precisa (Vt), estabelecendo uma condutância que representa um peso. Quando uma tensão de entrada é aplicada, a corrente através da célula iguala o produto da entrada e do peso armazenado.
Arquitetura de Memória Multi-Level
A Figura 4 mostra a cross-section de uma bitcell ESF3. A célula inclui cinco terminais — Control Gate (CG), Word Line (WL), Erase Gate (EG), Source Line (SL) e Bitline (BL). EG de alta tensão programa o floating gate, enquanto biasing de baixa tensão nos outros terminais lê ou escreve a célula.
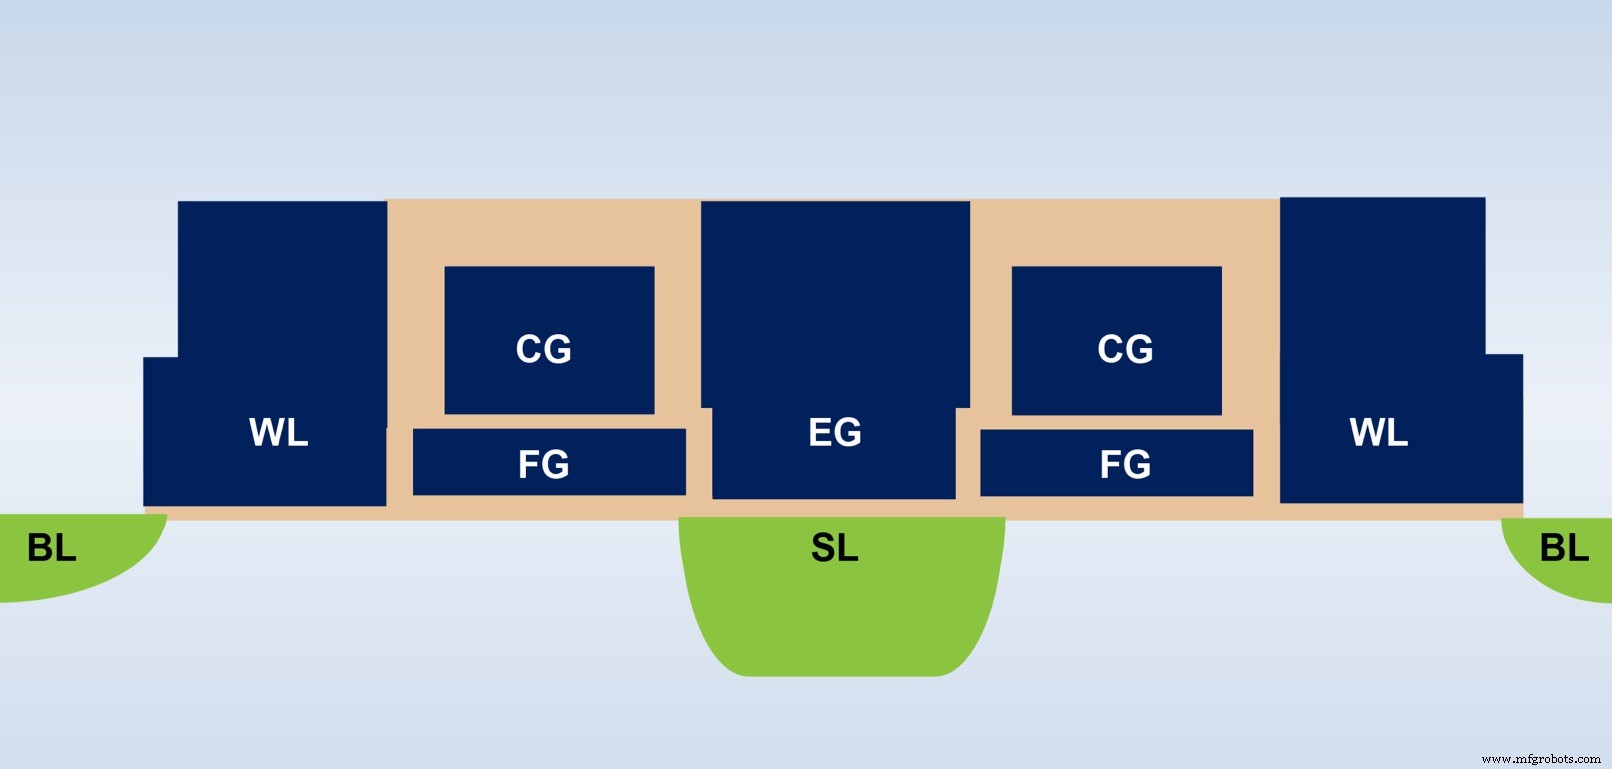 Figura 4: Célula SuperFlash ESF3. (Fonte: Microchip Technology)
Programação fine-grained afina o Vt do floating-gate para produzir uma curva I-V específica. A Figura 5 demonstra um exemplo de 2-bit onde quatro níveis distintos de Vt geram quatro respostas de corrente separadas quando uma tensão CG fixa é aplicada.
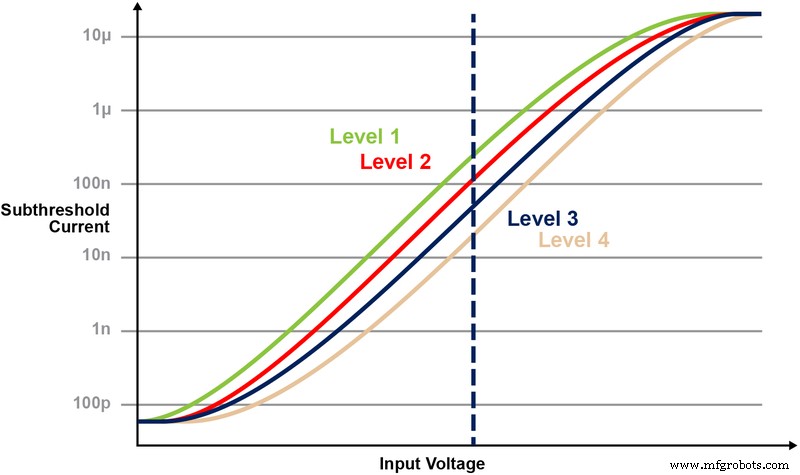 Figura 5: Programando Níveis Vt em Célula ESF3. (Fonte: Microchip Technology)
MAC no Array de Memória
A condutância gm de cada célula incorpora um peso treinado. A corrente Iout = gm · Vin implementa o passo de multiplicação. Ligando muitas células em paralelo, as correntes de coluna somam naturalmente, rendendo a operação de acumulação. A Figura 6 visualiza um array 2×2 realizando dois MACs e uma acumulação.
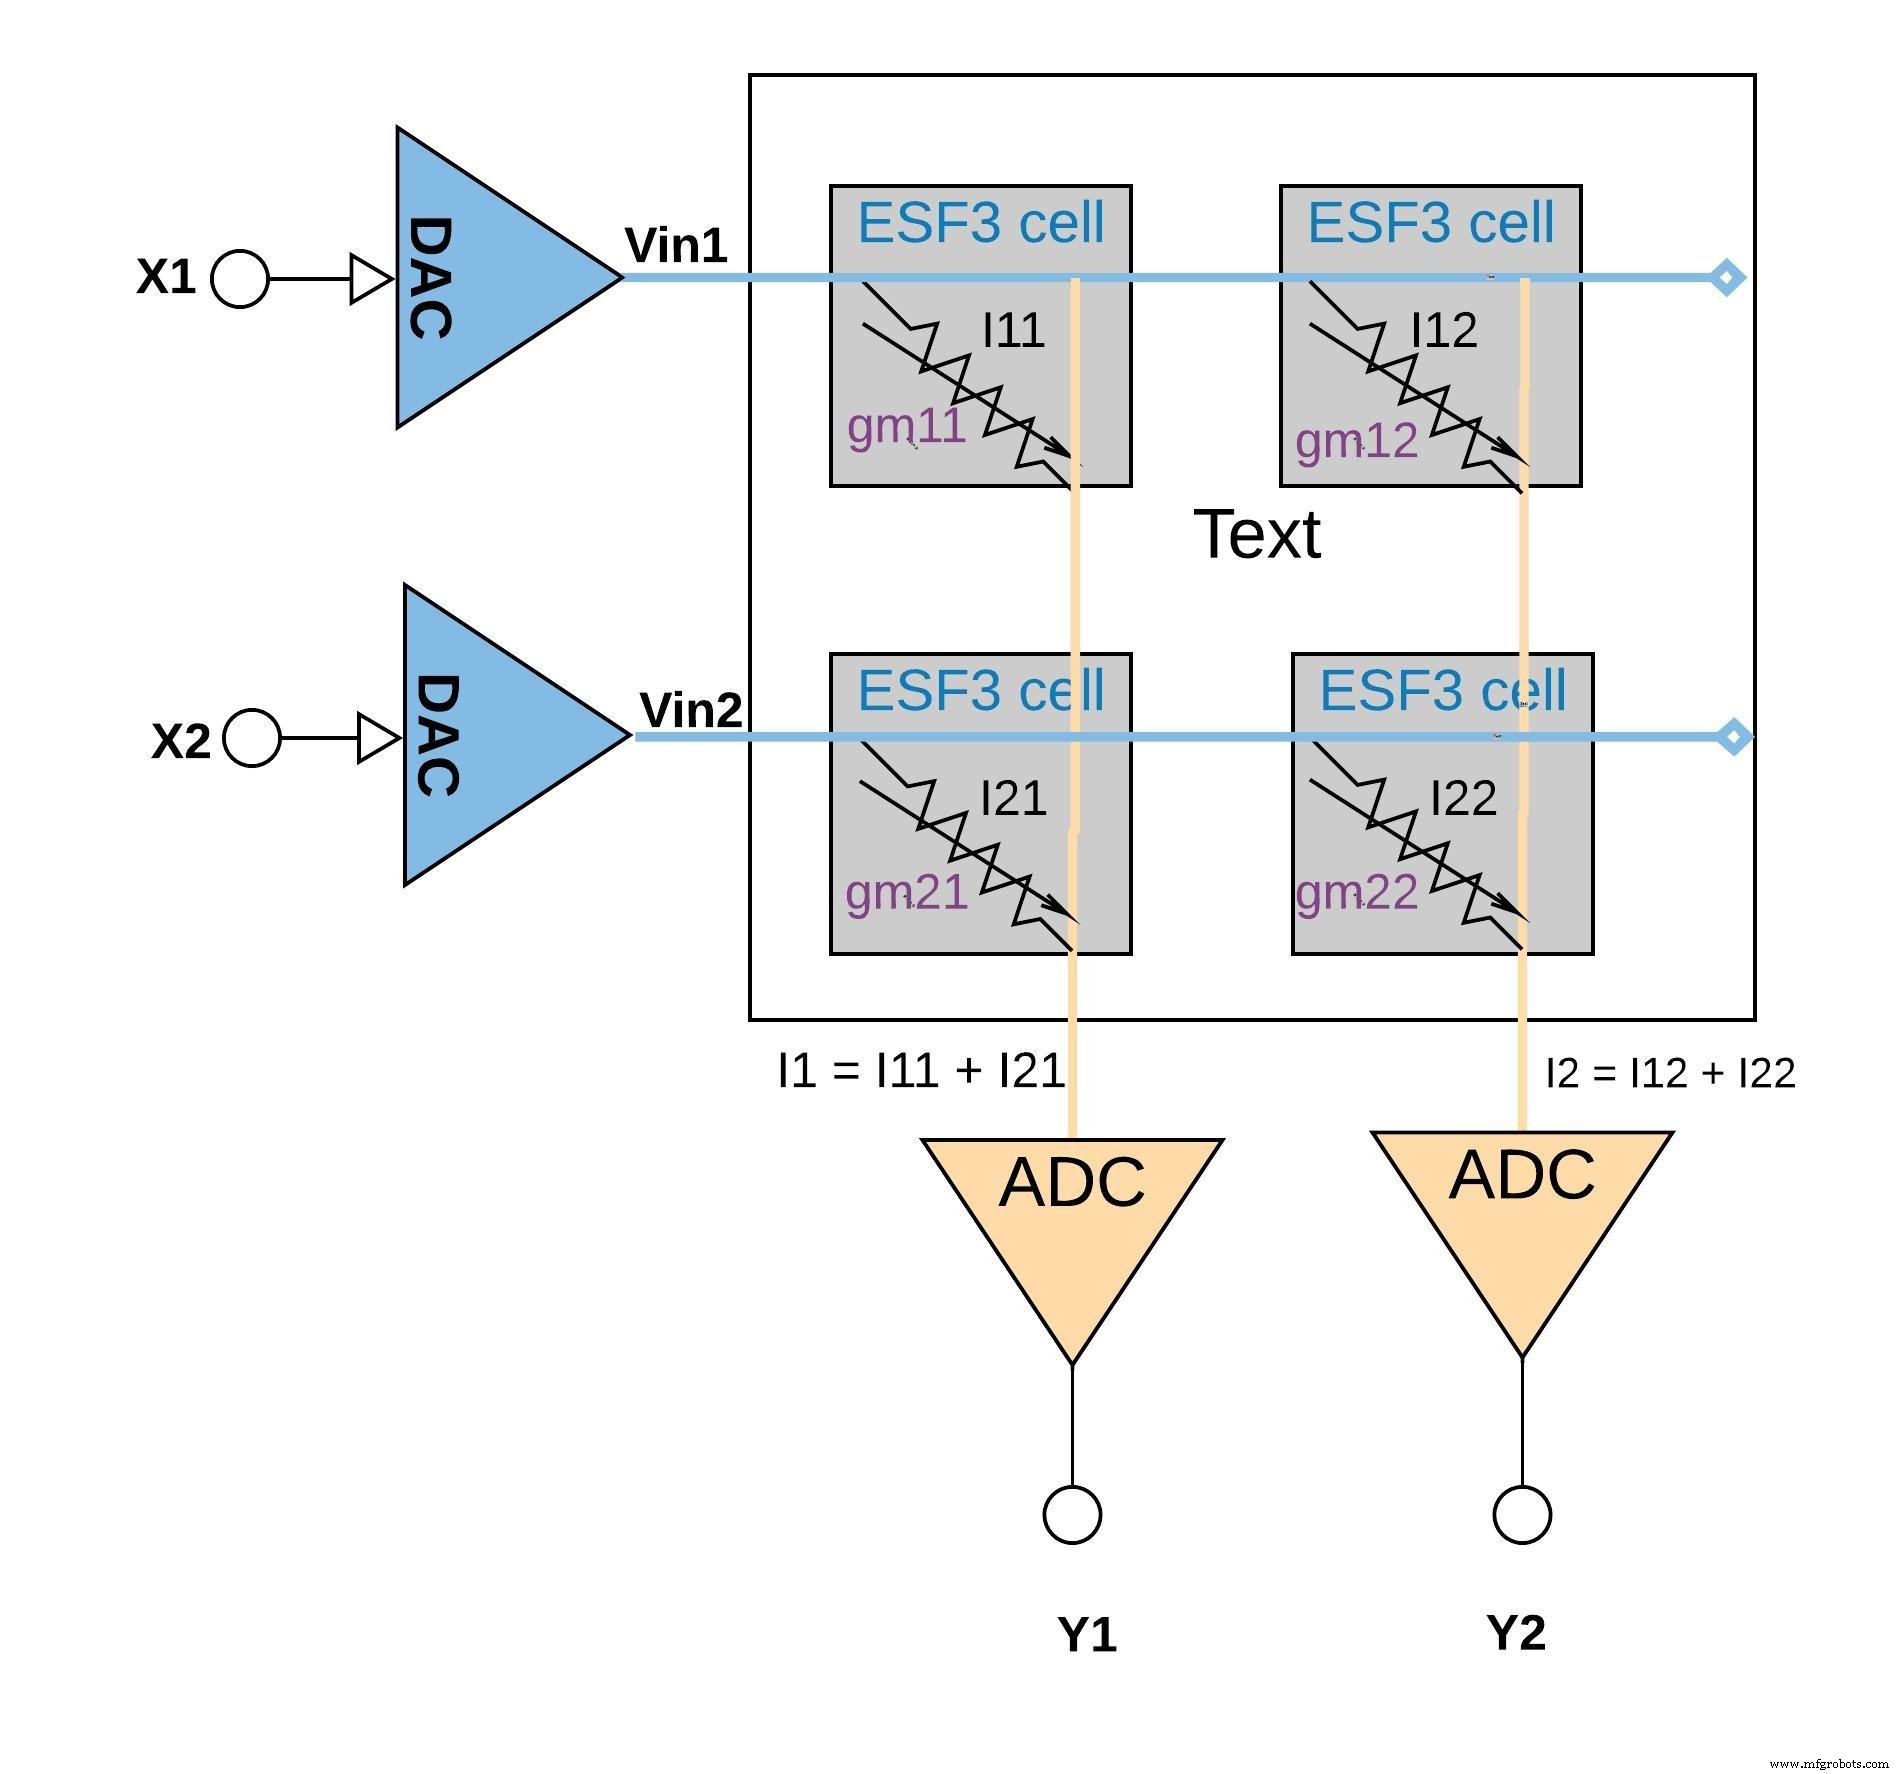 Figura 6: Operação Multiply-Accumulate com Array ESF3 (2×2). (Fonte: Microchip Technology)
Em escala maior, uma matriz de pesos pode ser mapeada em um único array de memória. A Figura 7 mostra o layout da matriz para uma fully connected layer.
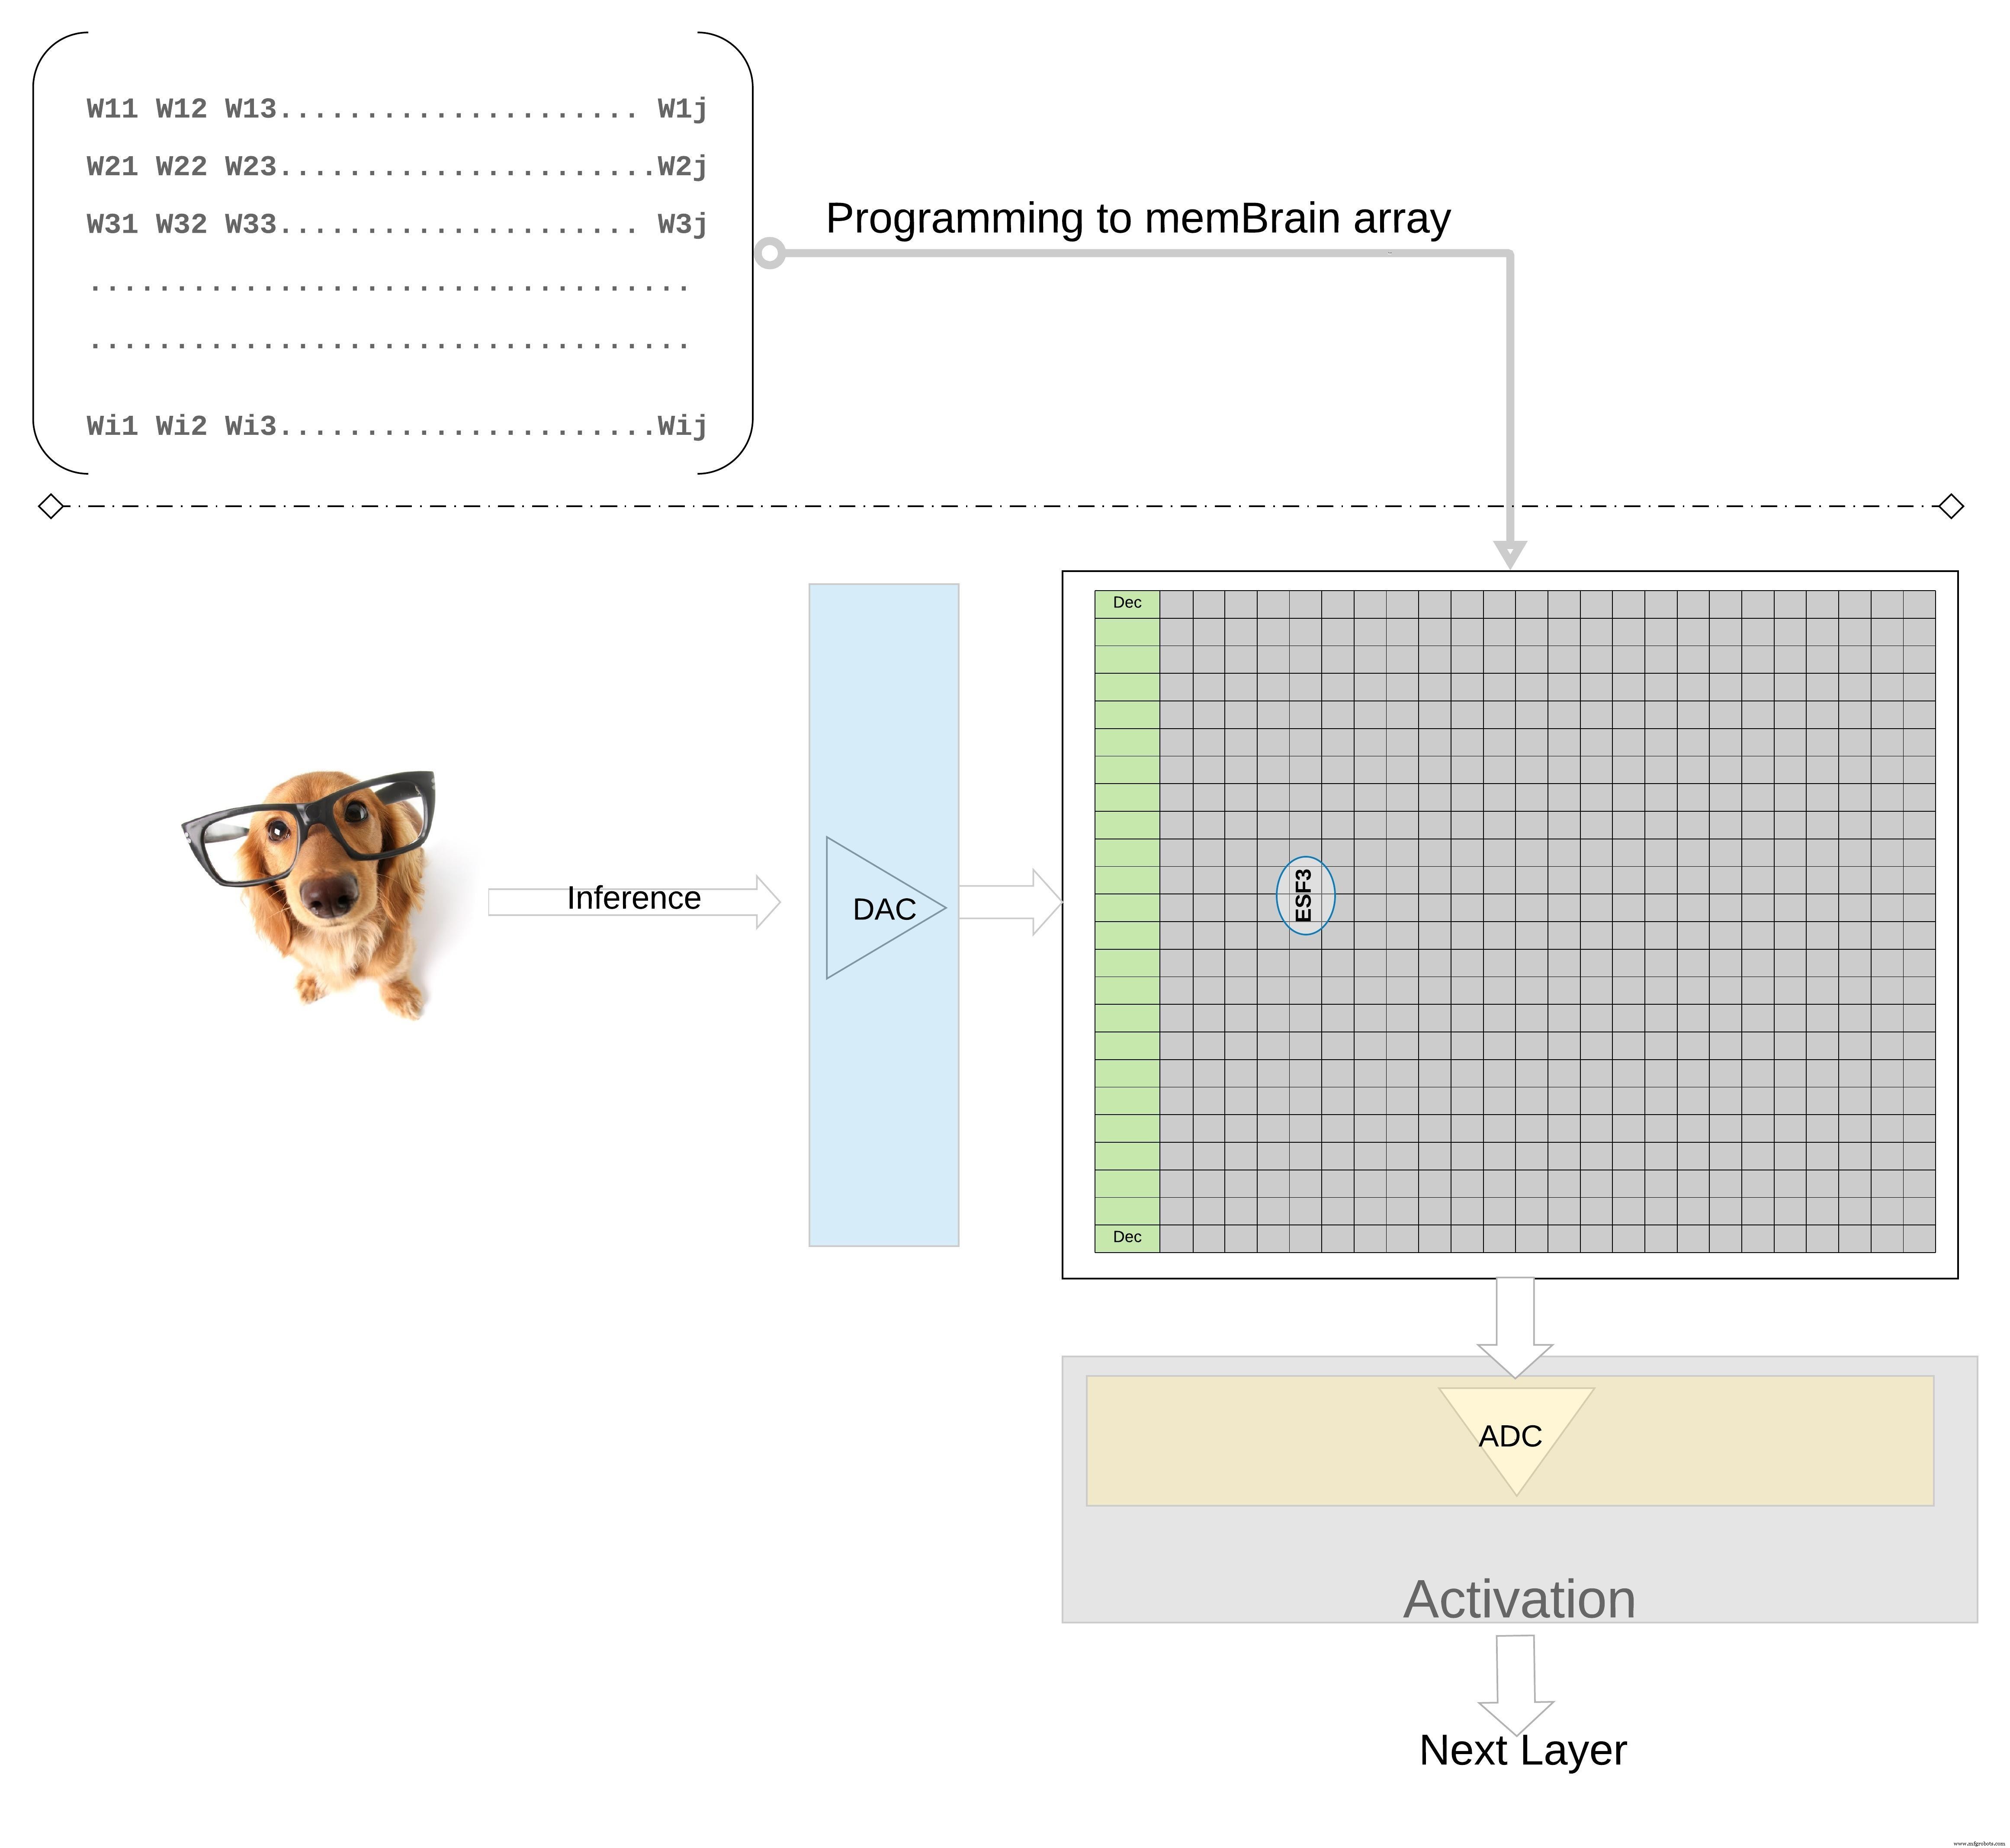 Figura 7: Array de Memória de Matriz de Pesos para Inferência. (Fonte: Microchip Technology)
O fluxo de inferência é direto: dados de sensor são digitalizados, convertidos a tensão analógica por um DAC, alimentados no array, e as correntes de coluna resultantes são digitalizadas por um ADC para estágios subsequentes de ativação e pooling.
Modularidade e Escalabilidade
Tiles memBrain são projetados para serem empilhados. A Figura 8 mostra uma configuração 3×4 onde múltiplos tiles compartilham uma interconexão analógico-digital comum. Dados movem-se através de tiles via bus compartilhado, permitindo construção de redes profundas sem um único die monolítico.
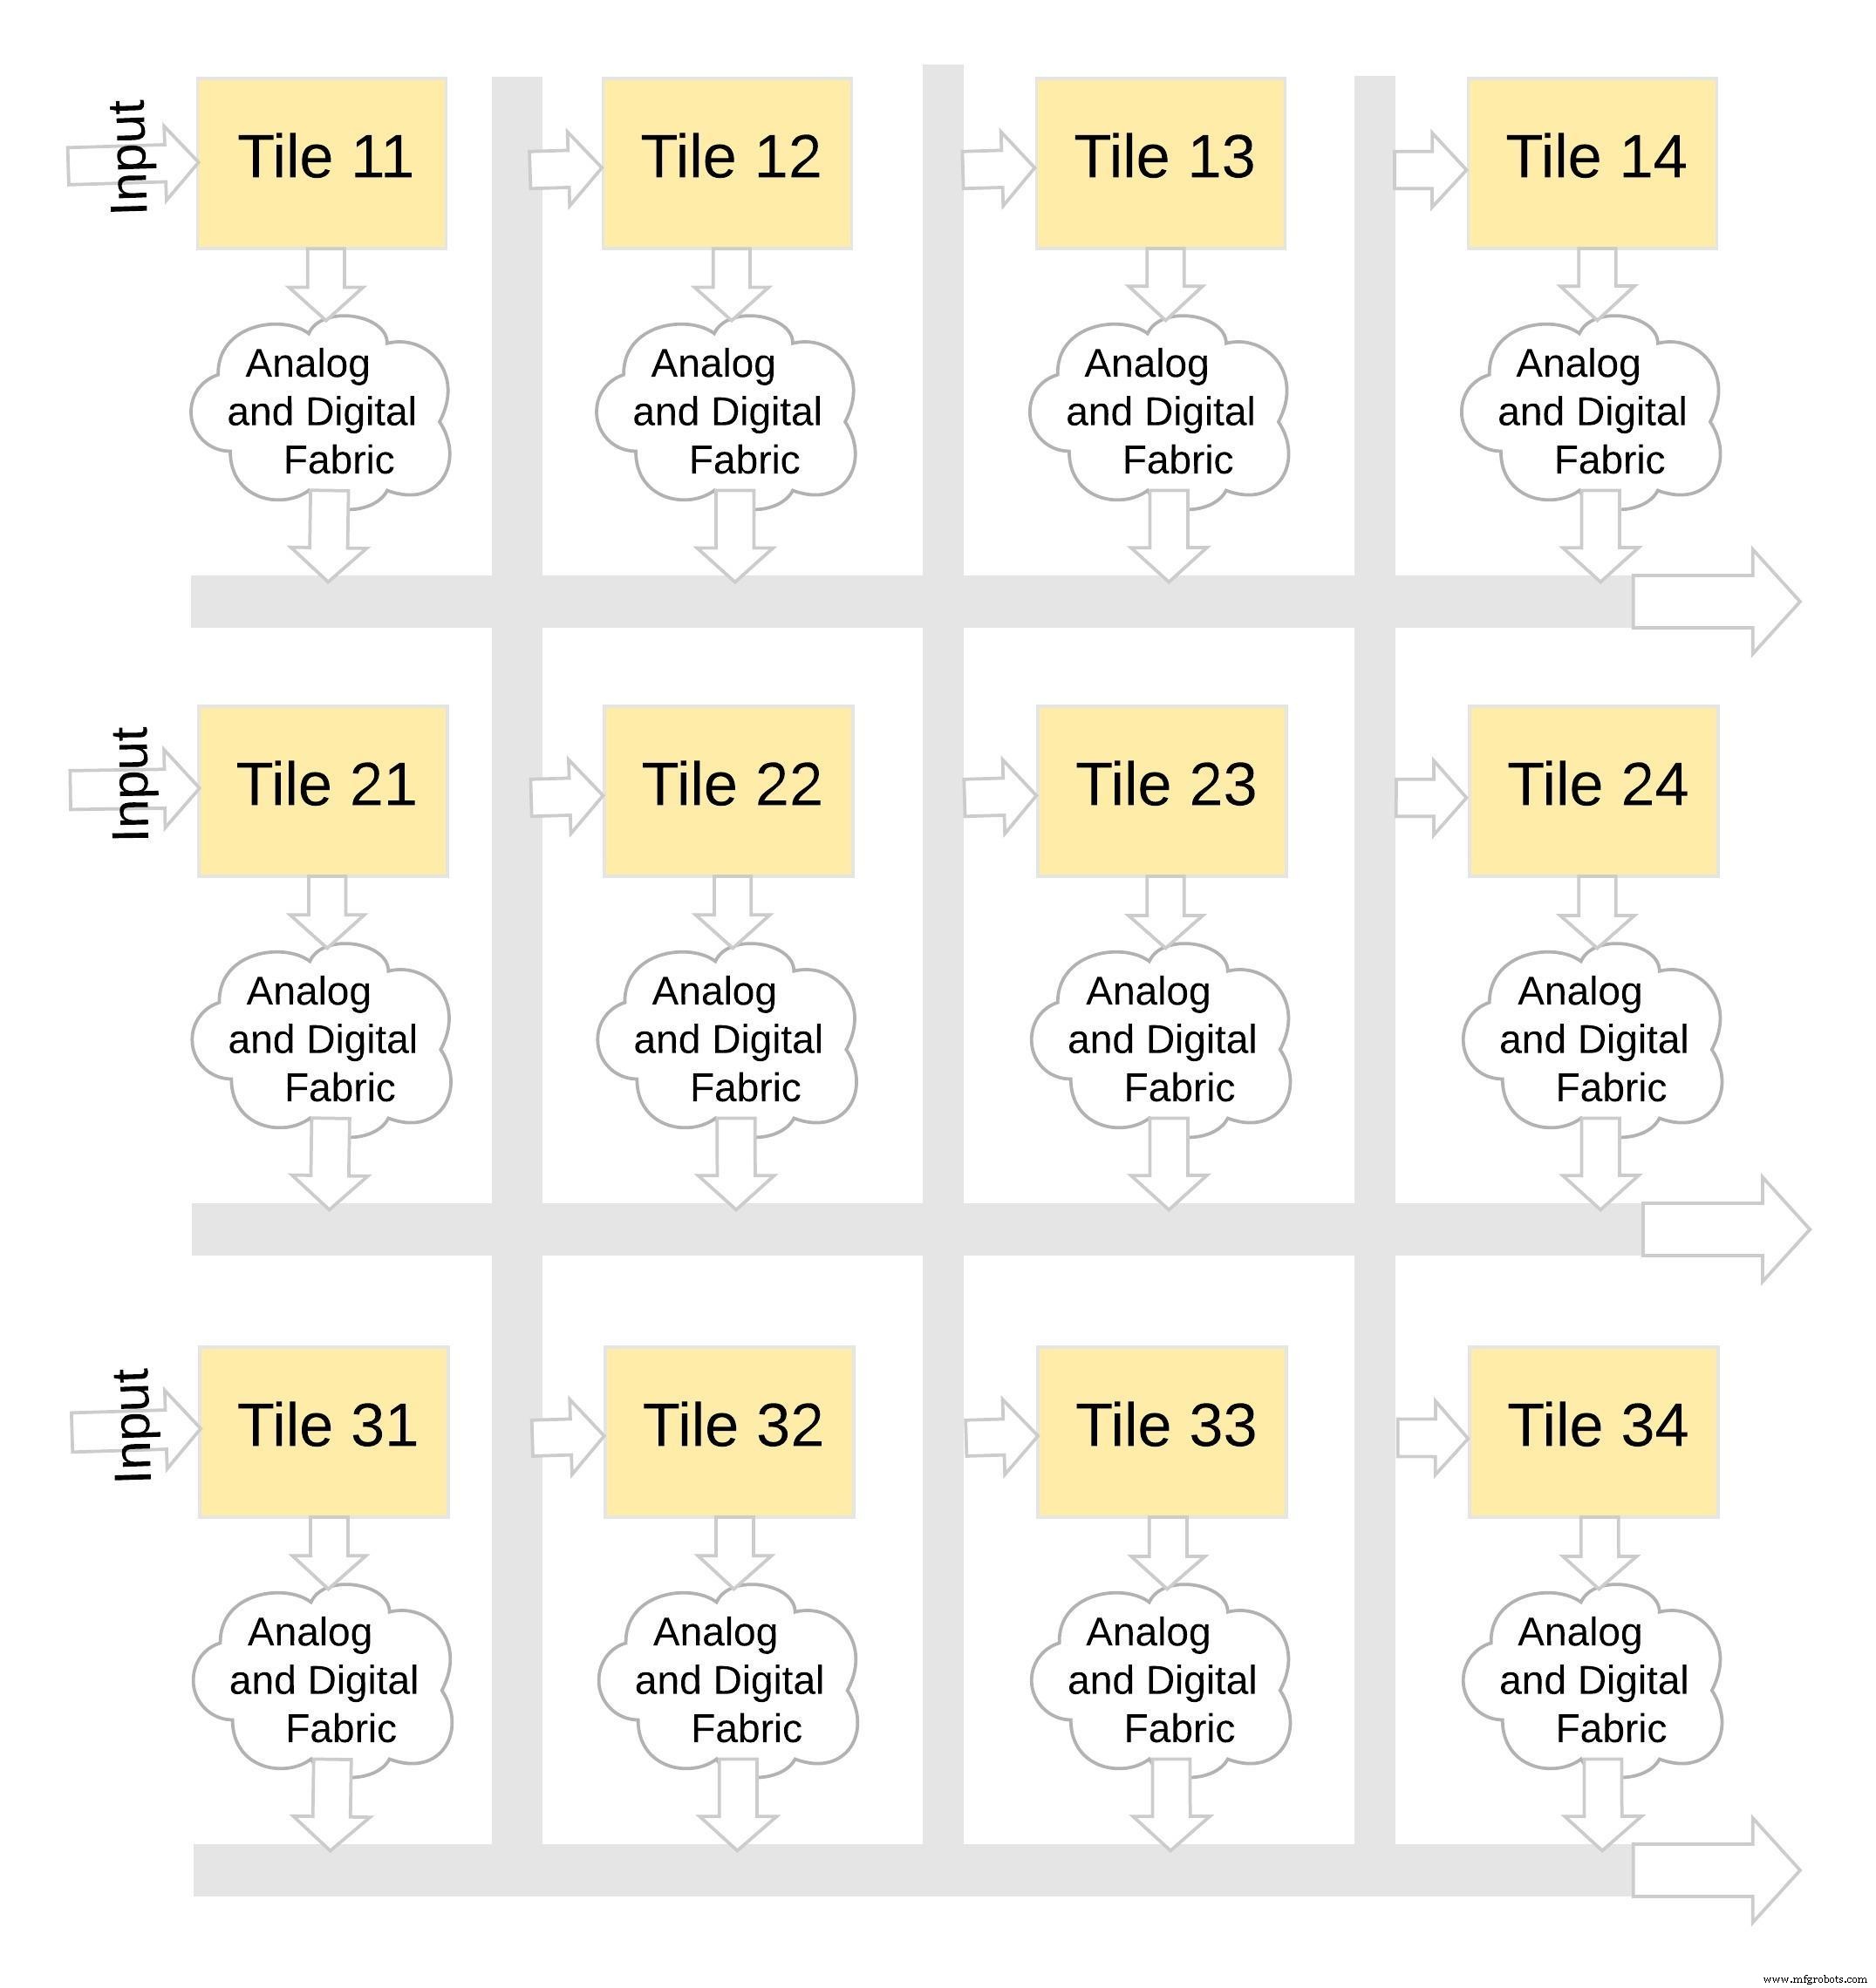 Figura 8: memBrain™ é Modular. (Fonte: Microchip Technology)
Software Development Kit (SDK)
O SDK acompanhante é framework-agnóstico. Seja você treine em TensorFlow, PyTorch ou outra biblioteca, o SDK lida com quantização de modelo, mapeamento e deployment para hardware memBrain. A Figura 9 delineia o workflow de treino a inferência.
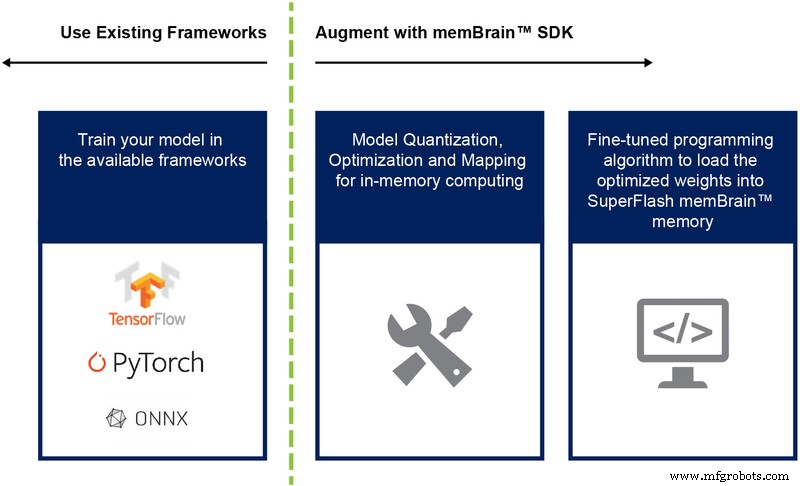 Figura 9: Fluxo memBrain™ SDK. (Fonte: Microchip Technology)
Principais Vantagens
- Ultra-baixa potência — Computação in-memory elimina movimento de dados, células flash operam sub-threshold, e nenhuma potência de standby é necessária. A arquitetura também explora esparsidade, pois pesos ou inputs zero deixam células ociosas.
- Footprint compacto — A célula split-gate de 1.5-transistor armazena valor de 4-bit, enquanto SRAM de 6-transistor requereria 24 transistores para os mesmos dados. Resultado é área de die dramaticamente menor.
- Custo de desenvolvimento reduzido — Aproveitando processos flash maduros e evitando necessidade de geometrias ultra-densas, custos de mask set e lead times são significativamente baixos comparados a ASICs desenhados para edge AI.
Edge AI promete aplicações transformadoras, mas potência e custo permanecem fatores limitantes. Computação analógica in-memory, respaldada por tecnologia flash multi-level comprovada, oferece um caminho prático e de baixo custo para trazer inferência inteligente direto ao sensor.
Integrado
- Como a computação de borda pode transformar a TI empresarial: uma perspectiva equilibrada
- Por Que a Computação em Nuvem Capacita as Equipes de TI
- Edge Computing Desmistificado: Casos de Uso Práticos em Transporte, Utilities e Manufatura
- Edge Computing: 5 Armadilhas Potenciais — e Como Superá-las
- Aproveitando Dados do IIoT para Impulsionar Lucratividade na Manufatura Enxuta
- Edge Computing: O Catalisador Impulsionando a Indústria 4.0 Adiante
- Como as Quedas de Energia Ameaçam Suas Fontes de Alimentação — e Como Protegê-las
- 6 Razões Convincentes para Adotar a Computação de Borda
- Edge Computing e 5G: Impulsionando a Transformação Empresarial
- Como Pequenas Oficinas de Fabricaçăo Podem Adotar Soluçőes Digitais de Forma Custo-Efetiva