



Dominando o Ciclo de Vida da Ciência de Dados: Um Guia Completo
Desde a chegada dos big data, a ciência da computação moderna tem alcançado novos recursos e benchmarks de poder de processamento. Hoje, não é incomum encontrar aplicações que produzem conjuntos de dados de 100 terabytes ou mais, o que é considerado big data.
Com volumes tão grandes de informação em mãos, é fácil se desorganizar e perder tempo com conteúdo inútil. Estas são duas razões pelas quais é muito importante seguir uma metodologia que aumente a eficácia e a eficiência de um projeto de big data.
Figura 1. A ciência de dados moderna trabalha com conjuntos de dados muito grandes, também conhecidos como big data.
O ciclo de vida da ciência de dados fornece uma estrutura que ajuda a definir, coletar, organizar, avaliar e implantar projetos de big data. É um processo iterativo consistindo em uma série de etapas organizadas em uma sequência lógica, facilitando feedback e pivôs.
Como é a sequência do ciclo de vida? A resposta é: não existe um único modelo universal que todos seguem. Muitas empresas que realizam projetos de big data adaptam o ciclo de vida da ciência de dados aos seus processos de negócios, geralmente incluindo mais etapas. Apesar disso, todos os muitos modelos e fluxos de processo têm denominadores comuns. Este artigo usará o modelo de processo CRISP-DM, que é um dos primeiros e mais populares modelos de ciclo de vida da ciência de dados.
O Modelo CRISP-DM
CRISP-DM significa Processo Padrão da Indústria para Mineração de Dados. Foi publicado pela primeira vez em 1999 pela ESPRIT, um programa europeu para impulsionar a pesquisa em tecnologia da informação (TI). O modelo CRISP-DM consiste em seis etapas ou fases que guiam o projeto de big data. Ele incentiva as partes interessadas a pensar no negócio, colocando e respondendo perguntas importantes sobre o problema.
Vamos revisar em detalhes as seis fases do modelo CRISP-DM.
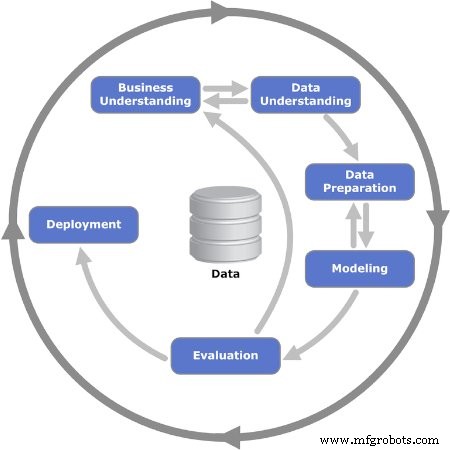
Figura 2. As seis fases iterativas do modelo CRISP-DM são mostradas. Imagem usada com cortesia de Kenneth Jensen
Fase 1: Entendimento do Negócio
A primeira fase consiste em várias tarefas que definem o problema e estabelecem metas. É quando os objetivos do projeto são definidos com foco no negócio — ou, em outras palavras, no cliente. Normalmente, a equipe montada para trabalhar em um projeto de big data deve entregar uma solução ao cliente, que pode ser outra área ou departamento dentro da empresa.
Uma vez estabelecida a necessidade ou problema do negócio, o próximo passo é definir critérios de sucesso. Podem ser indicadores-chave de desempenho (KPIs) ou acordos de nível de serviço (SLAs), que fornecem meios objetivos para avaliar progresso e conclusão.
Em seguida, a situação do negócio precisa ser analisada para identificar riscos, planos de rollback, medidas de contingência e, mais importante, disponibilidade de recursos. Um plano de projeto é traçado, incluindo marcos e recursos.
Fase 2: Entendimento dos Dados
Uma vez estabelecidos os fundamentos na fase anterior, é hora de focar nos dados. Esta fase começa com uma definição inicial do que se acredita ser necessário, e então documenta alguns detalhes sobre eles: onde encontrá-los, tipo de dado, formato, relacionamentos entre diferentes campos de dados, etc.
Com a primeira documentação pronta, o próximo passo é executar a primeira coleta de dados. Isso fornece um instantâneo útil de como a estrutura está se formando. Esse instantâneo de informação é então avaliado quanto à qualidade.
Fase 3: Preparação dos Dados
A terceira fase reforça a fase anterior e prepara o conjunto de dados para modelagem. Campos de dados da primeira coleta são mais curados, e qualquer informação considerada desnecessária é removida do conjunto: isso é chamado de limpeza dos dados.
Além disso, uma informação específica pode precisar ser derivada de outras informações disponíveis; outras vezes, deve ser combinada. Em outras palavras, os dados precisam ser processados para produzir um formato final.
Fase 4: Modelagem
A tarefa mais importante nesta fase é selecionar um algoritmo para processar os dados coletados. Neste contexto, um algoritmo é um conjunto de etapas sequenciais e regras programadas em software de computador projetado para projetos de big data.
Muitos algoritmos podem ser usados: regressões lineares, árvores de decisão e máquinas de vetores de suporte são alguns exemplos. Escolher o algoritmo certo para resolver o problema requer habilidades que cientistas de dados experientes têm.
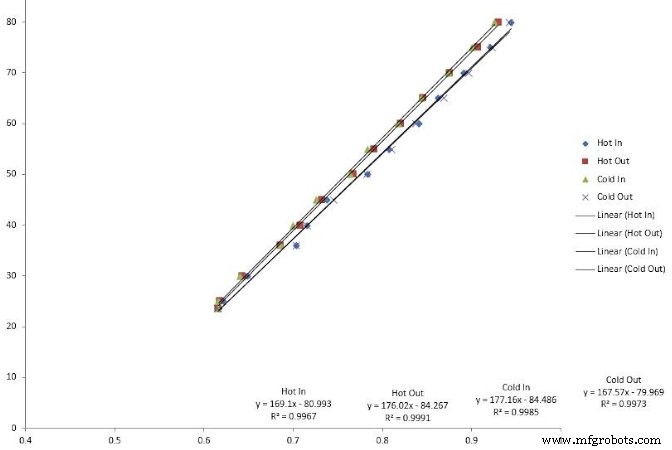
Figura 3. Regressão linear é um tipo de algoritmo usado em modelagem de big data.
O próximo passo é codificar o algoritmo no aplicativo de software. É também quando a fase de teste é planejada, que consiste em alocar conjuntos de dados específicos para teste e validação.
Fase 5: Avaliação
Às vezes, é difícil escolher um algoritmo desde o início. Quando isso acontece, cientistas executam vários algoritmos e analisam os resultados para chegar a uma decisão final. Uma vez concluída a fase de teste, os resultados são revisados quanto à completude e precisão.
Mais importante, esta é uma oportunidade para avaliar se os resultados levam a uma solução. No modelo iterativo, este é um cruzamento crucial onde grandes sequências de iteração podem ser lançadas, ou uma decisão de avançar para a fase final pode ser tomada.
Fase 6: Implantação
É quando o projeto passa de um ambiente de teste para um ambiente de produção ao vivo. Planejar o cronograma e a estratégia de implantação é muito importante para reduzir riscos e tempo de inatividade potencial do sistema.
Embora o diagrama do modelo sugira que este é o fim do projeto, ainda há numerosos passos a seguir depois: monitoramento e manutenção. Monitoramento é um período de observação próxima, também conhecido como hyper care, imediatamente após o go-live. Manutenção é um processo semipermanente para manter e atualizar a solução implementada.
Big data é chamado assim por um motivo: há uma quantidade massiva de dados para analisar. Implementar um dos modelos de ciclo de vida da ciência de dados ajuda a decidir quais informações valem a pena manter e usar para processos como manutenção preditiva.
Tecnologia da Internet das Coisas
- Aproveitando Som: Transformando Transmissão de Dados Além dos Smartphones
- Terceirização de IA e Deep Learning na Saúde: Protegendo a Privacidade dos Dados
- Manutenção Preditiva: Aproveitando a Indústria 4.0 para Produção Ininterrupta
- Simplificando Ciclo de Vida SIM: Estratégia Digital para CSPs
- Democratizando a Internet das Coisas: IoT Satélite de Próxima Geração Traz Conectividade Universal e Acessível
- Desbloqueando o Valor dos Dados de IoT: Estratégias Seguras e Orientadas por Insights
- Capacitando Especialistas de Domínio com Ciência de Dados para Insights de Manufatura Mais Inteligentes
- Por Que Conectividade Direta de Dispositivos É o Próximo Marco na IoT Industrial
- Por Que Medições Analógicas Impulsionam Performance de Planta
- Tableau: Transformando Dados Brutos em Insights Estratégicos